記事
Jev:2026年もっとも話題になったAIモデルは、一言もしゃべらない
TypeSafe AIは4,000万ドルの資金調達とともにステルスを脱し、一文も書けないモデルを公開した。3日後、それはVercel AI Gateway史上導入が最も速いモデルになった。Jevが実際にやること、ベンチマークが見落としていること、そして私が最初に使いたい4つの場所。
2026年9月、もっとも話題になったAIモデルは、これまでに一度も文を書いたことがない。受信トレイの要約も、コードのリファクタリングも、会話もできない。質問を投げると、返ってくるのは数値だ。
ローンチから3日で、JevはVercel AI Gateway史上導入が最も速いモデルになった——24時間以内に有料チームの約13%が利用を開始し、GPT-5.6系の約2倍、Fable 5.1の6倍のペースだった。Cloudflare、LangChain、Langfuseも同じ週に連携をリリース。開発者はDoomでプレイし、Wikipediaを駆け抜け、7秒でチューリッヒ〜ロンドンの航空券を予約するデモを次々と投稿し始めた。
名前はJev。これが重要なのは賢いからではない。安くて速いからこそ、ありとあらゆる場所に置けるのだ、という点だ。
実際にリリースされたもの
2026年9月15日、TypeSafe AIは約2年のステルス期間を終え、DCVCがリードする4,000万ドルのシードラウンドを発表し、同時に第一弾モデルを公開した。同社はこれを System One Model(システム1モデル) と呼ぶ。
創業者は Diogo Almeida(CEO)、Erik Gafni(CTO)、Sasha Sheng(COO)。ローンチの報道を牽引したのは Almeida で、元OpenAI研究員にして InstructGPT 論文の共著者——RLHFをChatGPTにもたらし、過去4年の業界を定義したと言ってもいい仕事だ。
その彼のピッチは、異様に鋭い。RLHFが機能するのを何年も見続けた彼は、それが間違った問題を解いていると結論づけた。「瓶の中の稲妻を手にしているのに、役に立たない」というのが彼の言い方だ。
TechCrunch のローンチ記事での、彼の診断:
「問題は、我々が人間の言語を最適化してきたことだ……。4年間、人間の言語にはとても長けていた。だが自動化には役に立たない。コンピュータは違う言語を話しているからだ。」
賭けの中身は、一言で言えばこれだ。フロンティアラボは皆、モデルが散文を生成するのを上手くなる方向で競争している。だが、本番環境のAIの大半は散文を書いていない——ループの中で小さな判断を下している。チケットをどこへ振り分けるか。このツール呼び出しは危険か。40個あるボタンのどれを押すか。このチャンクをコンテキストに含めるべきか。
そういう仕事にチャットモデルを使うと、モデルは推論の段落を生成し、JSONオブジェクトをMarkdownフェンスで包み、出力のトークンすべてに課金される。Jevはその段落を飛ばす。
Jevの実際の動作
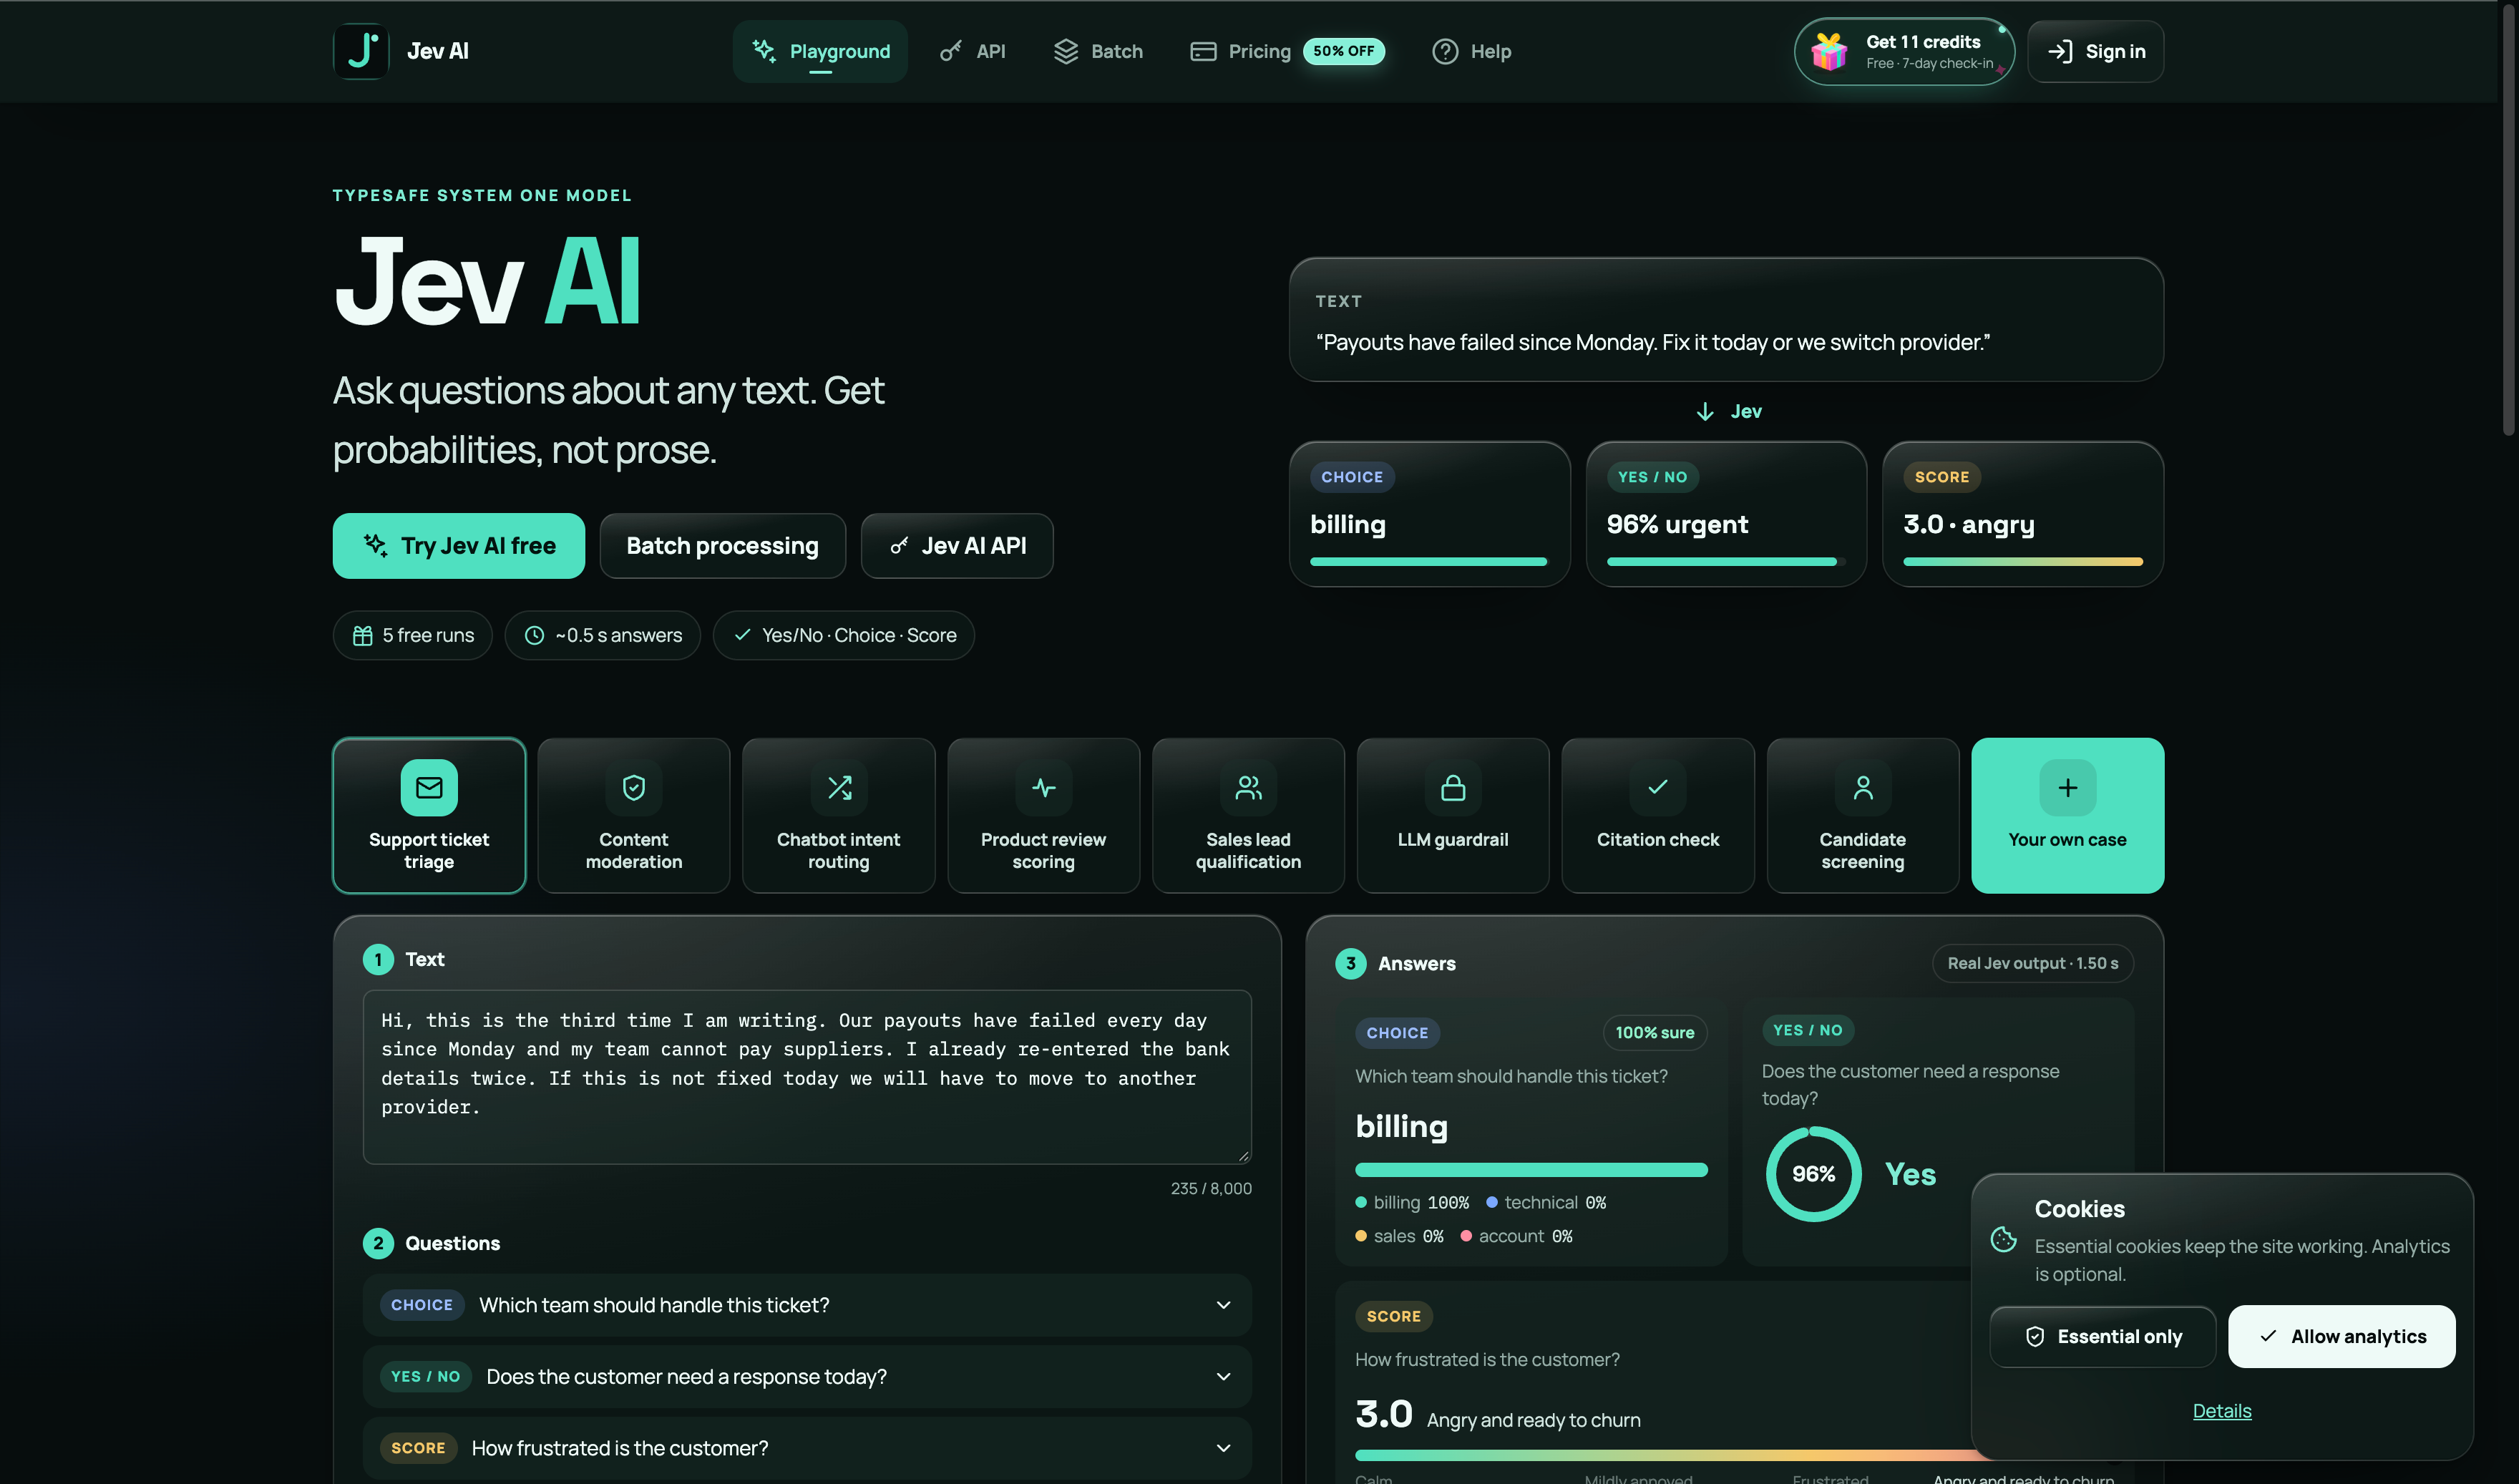
考え方はプロンプトより単純だ。state(任意の非構造化コンテキスト)と、それについてのquestions(質問のマップ)をPOSTする。返ってくるのは、確率分布とキャリブレーション済みの信頼度つきの型付き回答だ。
質問のプリミティブは正確に3つある:
Noul は0〜1の「真である確率」を返す。Choice は最大255個の選択肢からひとつを選び、各選択肢の確率と信頼度を返す。Score は2〜10段階の順序スケールで採点し、確率加重の連続値・分布・信頼度を返す。
Cloudflare ホスト版のコードが、その姿をいちばん手短に確認できる:
const response = await env.AI.run('typesafe/jev', {
  state: 'Help! My payouts have been failing for 3 days.',
  questions: {
    is_urgent: {
      type: 'noul',
      instructions: 'Does this convey urgency?',
      criteria: {
        true: 'Explicitly time-sensitive',
        false: 'No urgency expressed'
      }
    }
  }
})
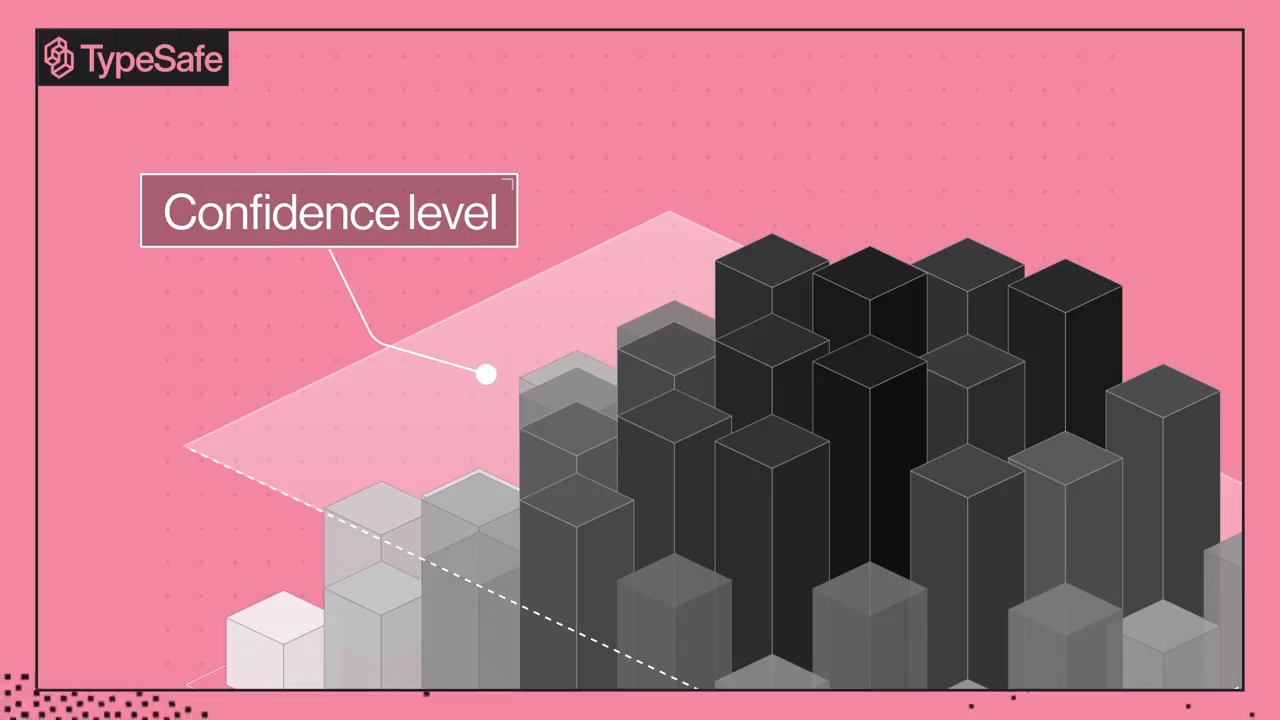
リクエストは地味な半分だ。大事なのが返り値——それは「答え」ではない。Jevがどれだけ確信しているか、残りの確率がどこへ行ったか、だ。
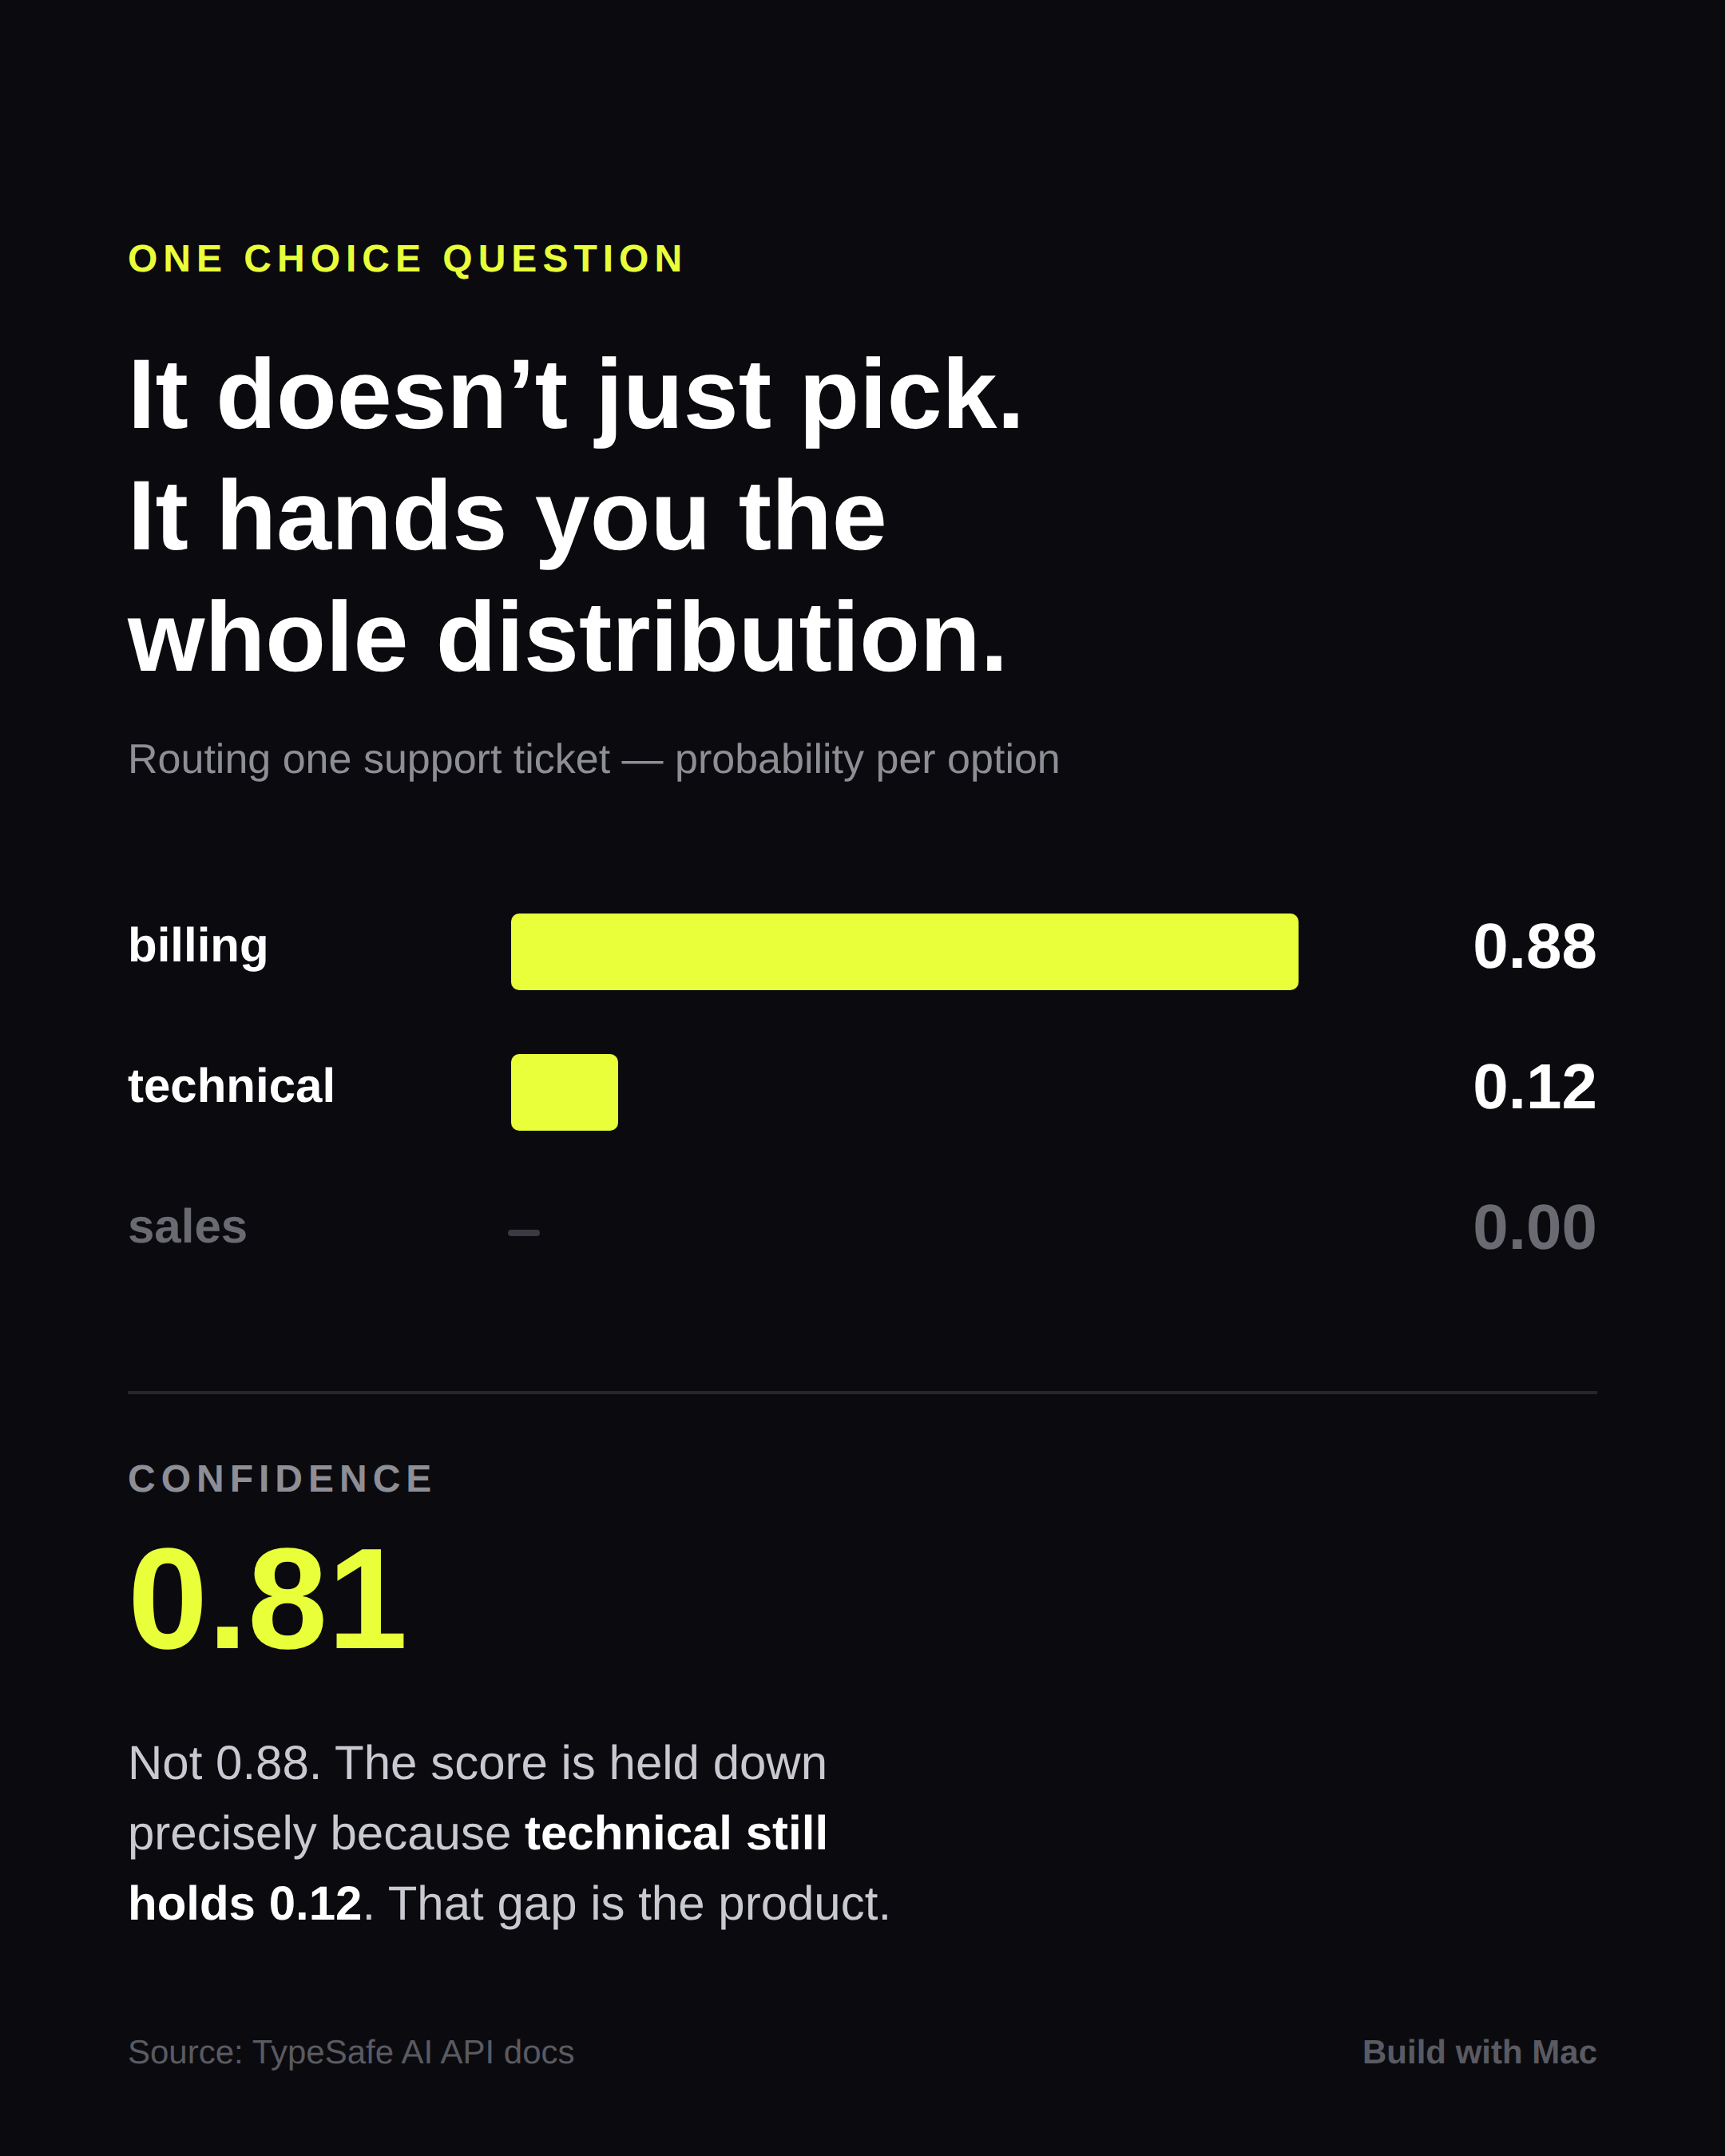
department という質問を例にとろう。Jevは「billing」を選んだだけではない——billing 0.88、technical 0.12 を返し、信頼度は 0.81 にとどまった。technical にまだ無視できない確率が残っているからだ。この「隙間」こそが製品の全部だ。チャットモデルなら「billing」と自信ありげに一文で答え、12%のことは何も教えてくれない。
これらの数字が出てきた生のレスポンスがこちら。TypeSafe のドキュメントでは3問のより完全な例が使われており、3つのプリミティブすべてが同じ state に一度に答えている:
{
  "model": "jev-1.13.0",
  "answers": {
    "is_urgent": {
      "type": "noul",
      "noul": 0.95
    },
    "department": {
      "type": "choice",
      "choice": "billing",
      "probabilities": { "billing": 0.88, "technical": 0.12, "sales": 0.0 },
      "confidence": 0.81
    },
    "frustration": {
      "type": "score",
      "score": 1.05,
      "legend": { "0": "Calm", "1": "Frustrated", "2": "Very angry" },
      "probabilities": { "0": 0.0, "1": 0.95, "2": 0.05 },
      "confidence": 0.92
    }
  },
  "usage": { "input_tokens": 304, "output_tokens": 18 }
}
output_tokens: 18 に注目。これが出力が無料である理由だ。
JSONモードのプロンプトも、出力パーサーも、モデルがオブジェクトをMarkdownフェンスで包み始めた日のためのリトライループもいらない。スキーマが契約であり、TypeSafe の主張は、モデルは「型エラーを起こさない」という点だ。
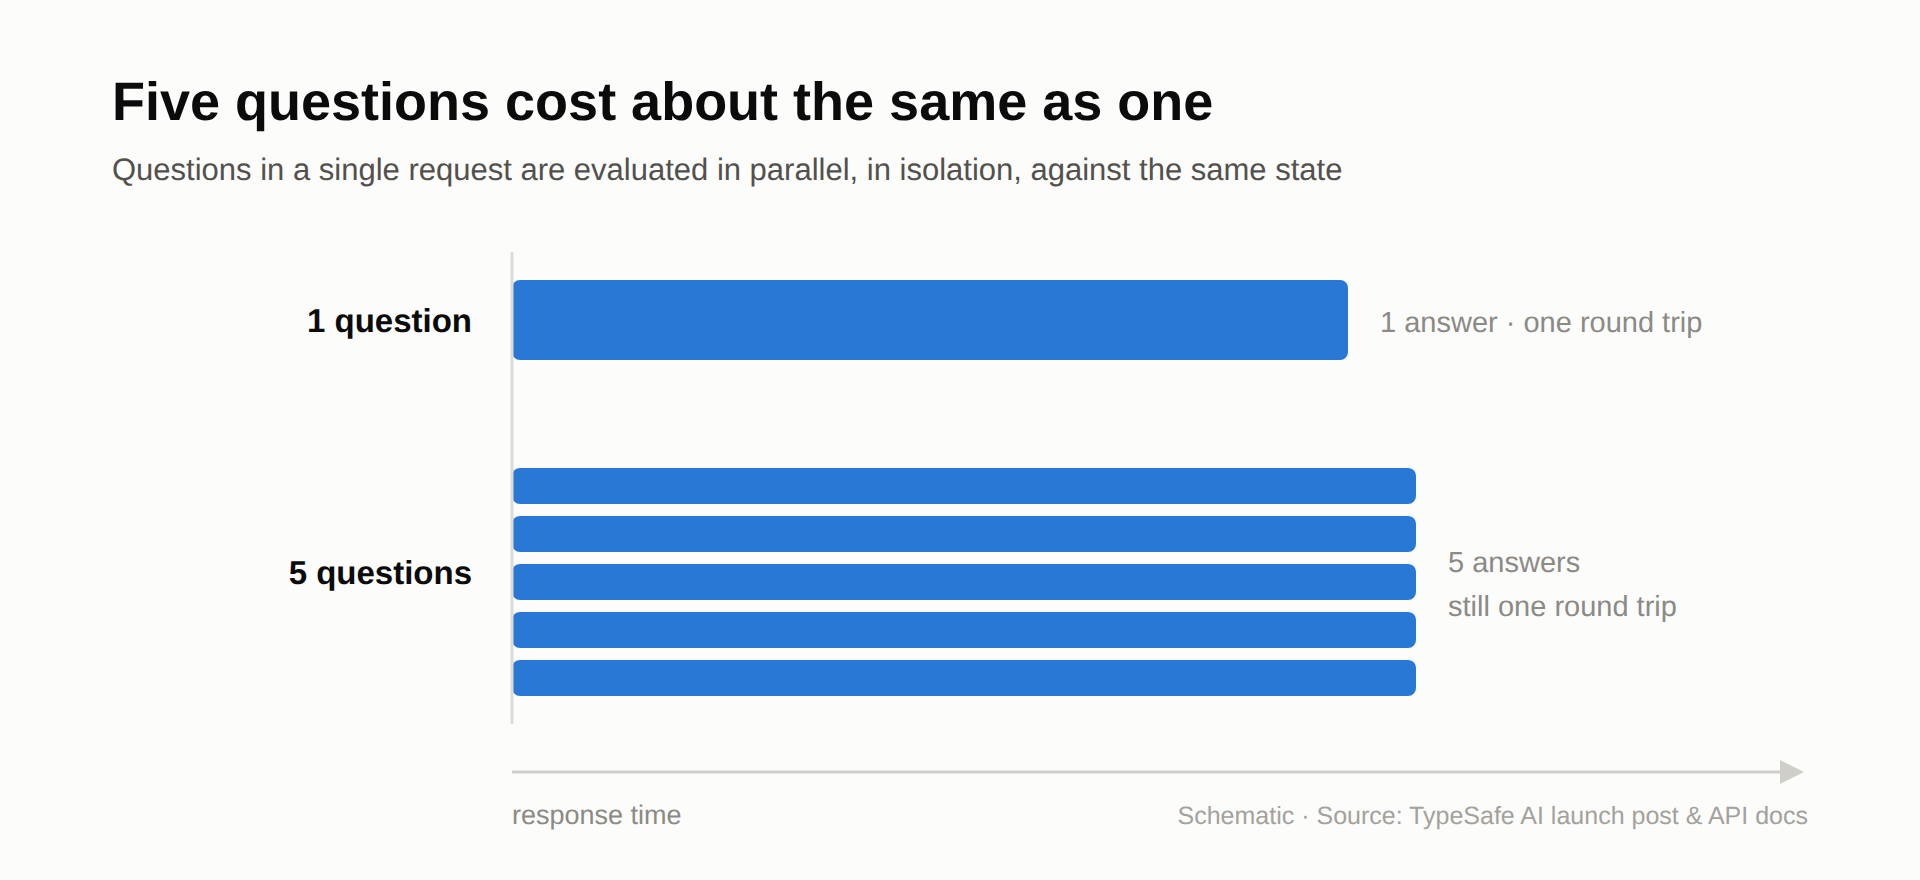
システム設計を変える部分:ひとつのリクエスト内の質問は、同じ state に対して並列かつ独立に評価される。4問目、5問目を足しても応答時間はほとんど動かない。だから慣用的なパターンは、ひとつの工夫ずくめのメガプロンプトではなく、判断をいくつかの狭い質問に分解し、自分のコードの中——実際にテストできる場所——で再構成することだ。
内部の仕組みはほとんど非公開——新しいアーキテクチャ、並列サンプラー、TypeSafeがRLCDと呼ぶ学習手法は、いずれも公表されていない。Almeida は学習データをすべて自社で生成していると言い、その賭けは「RLHFより上だ」と評価する。一方、ローンチのFAQは「データの出所はどこか」と尋ねては答えていない。
みんなが引用している数字
もっともクリーンな第三者測定は ably-labs/jev-pong——Ably Labs のコミュニティデモ(TypeSafe のベンチマークではない)——から来ている。Pongのボールはモデルの判断ごとに正確に一手進むので、判断のレイテンシは文字通りボールの速さになる。2026年9月17日収録、レーンごと45秒、Vercel AI Gateway経由:
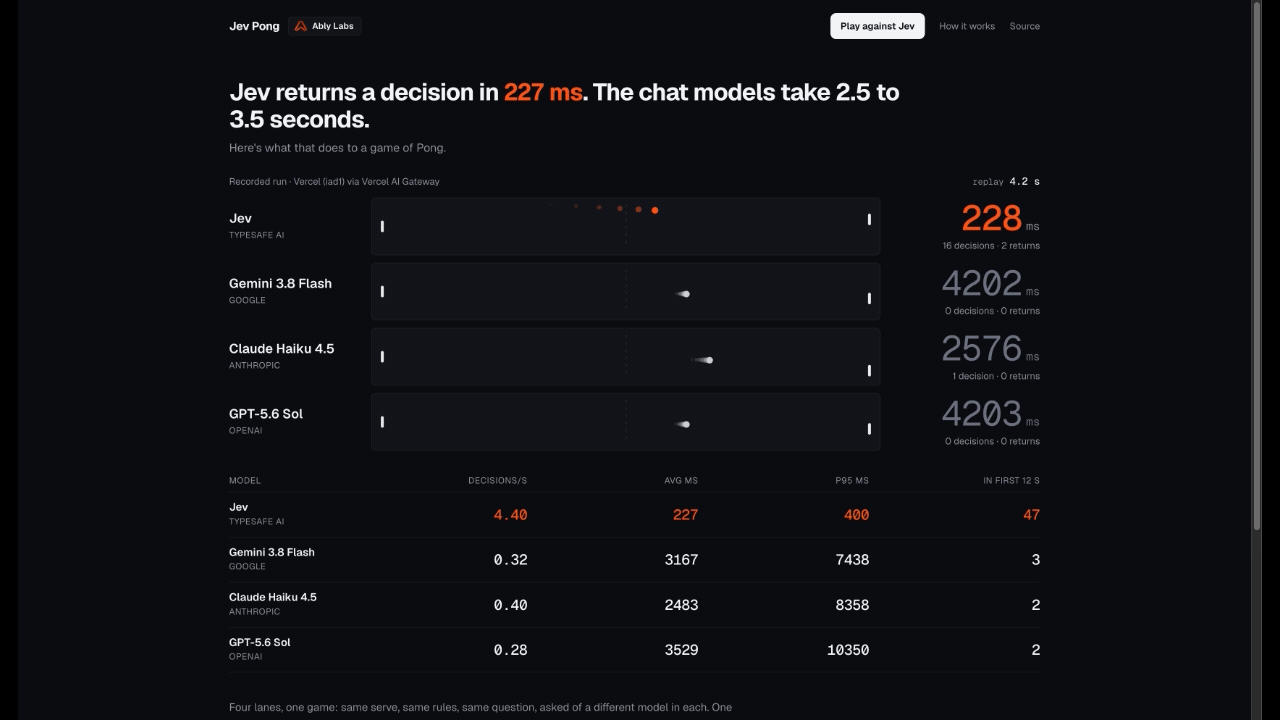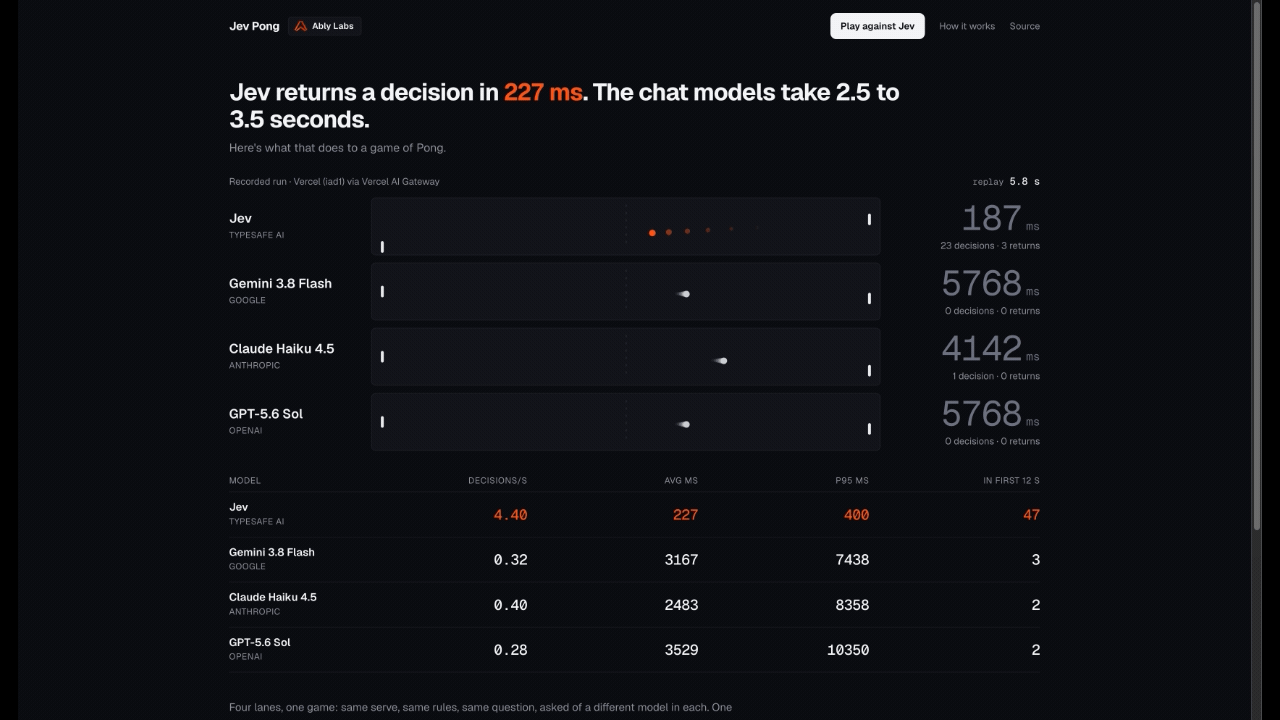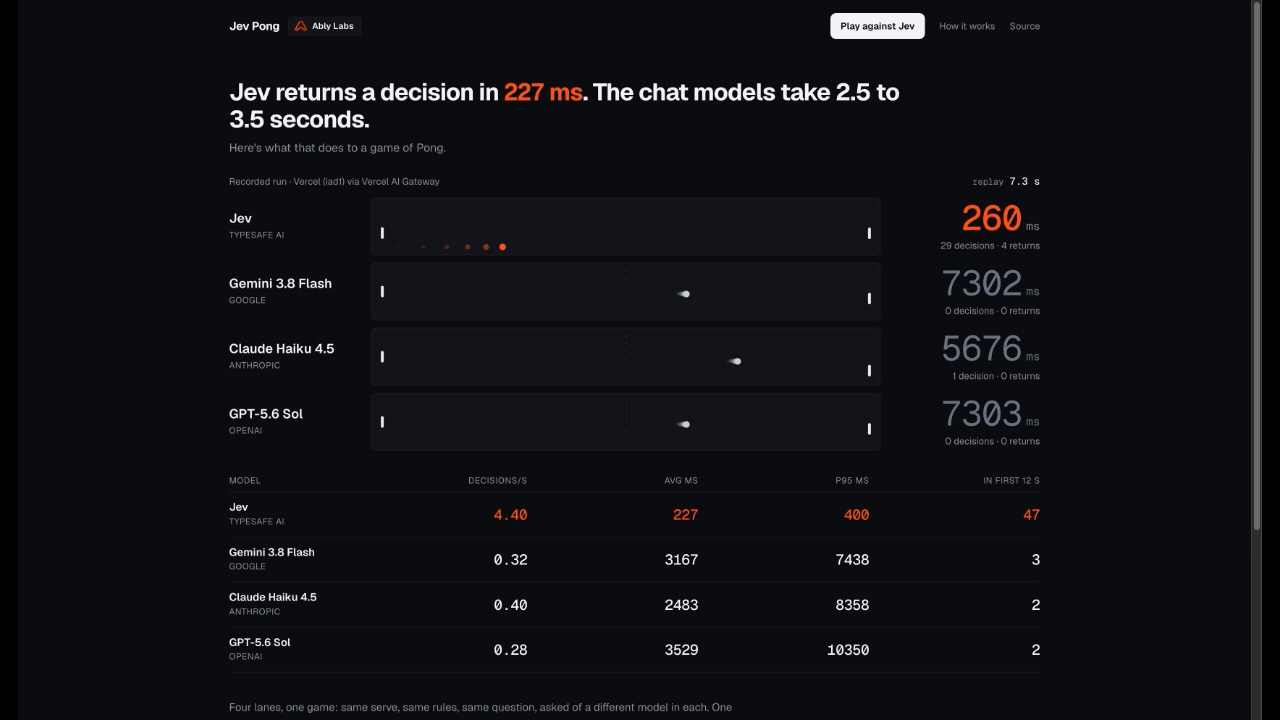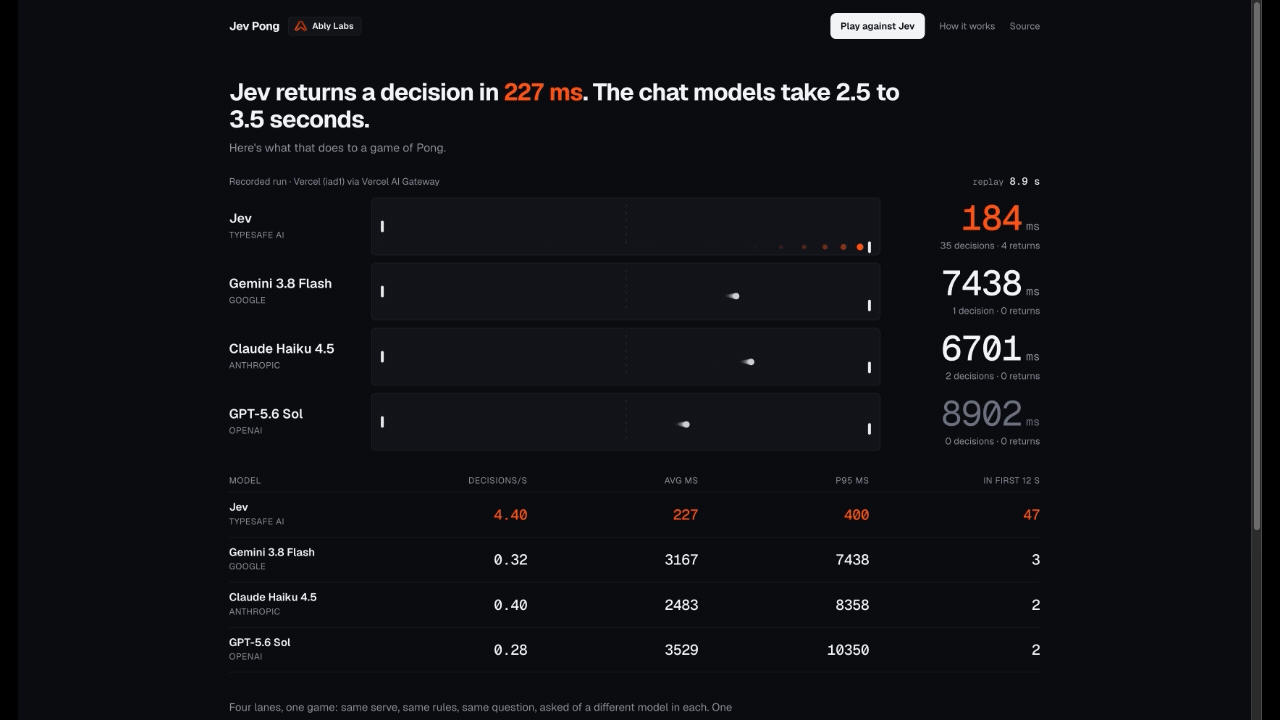
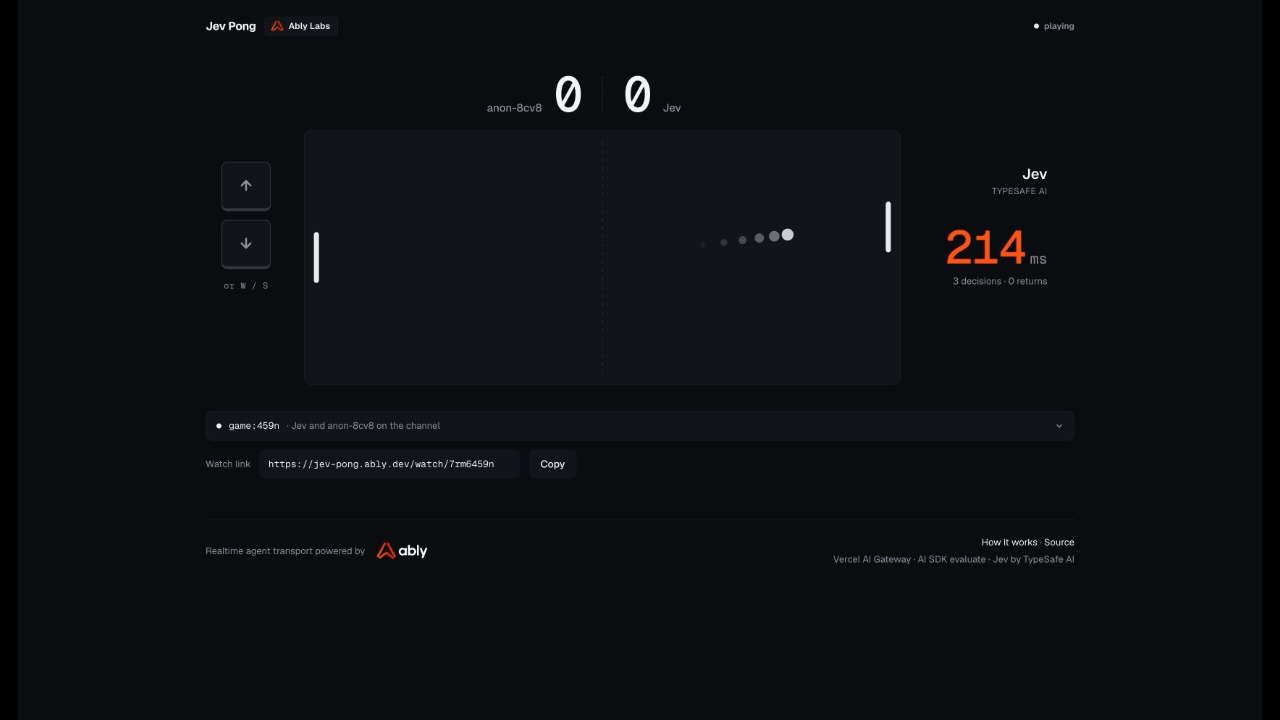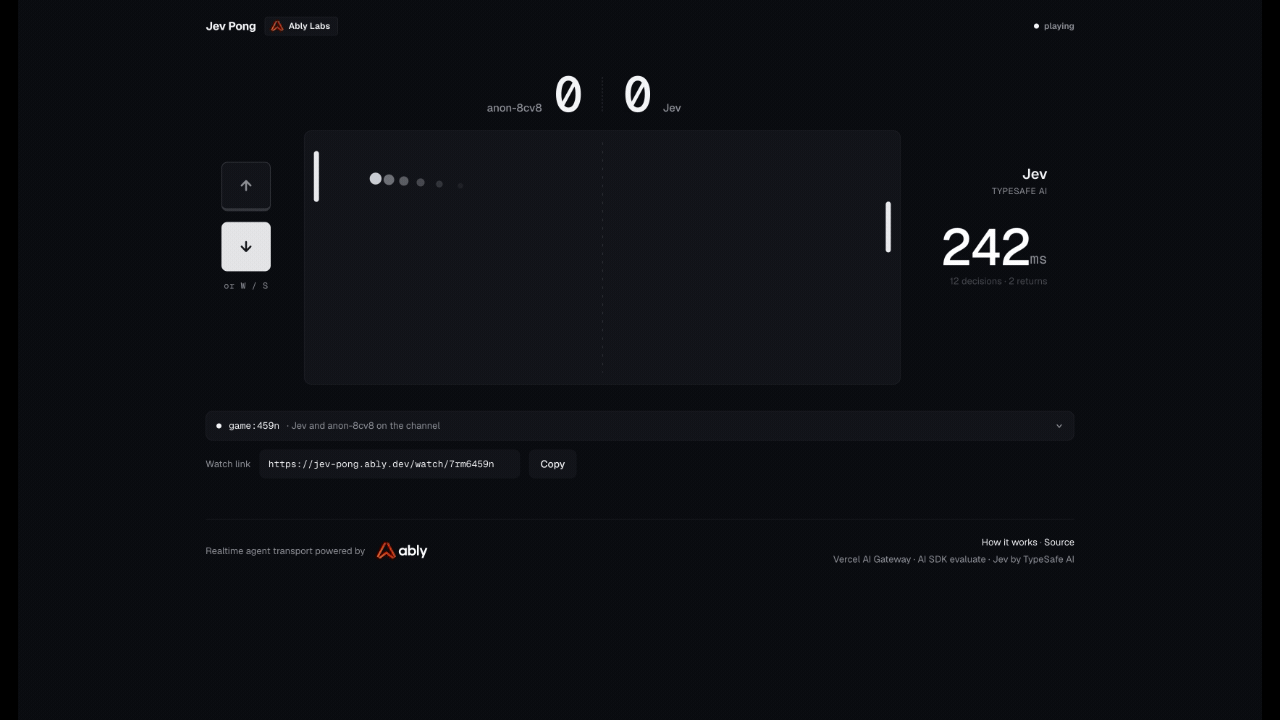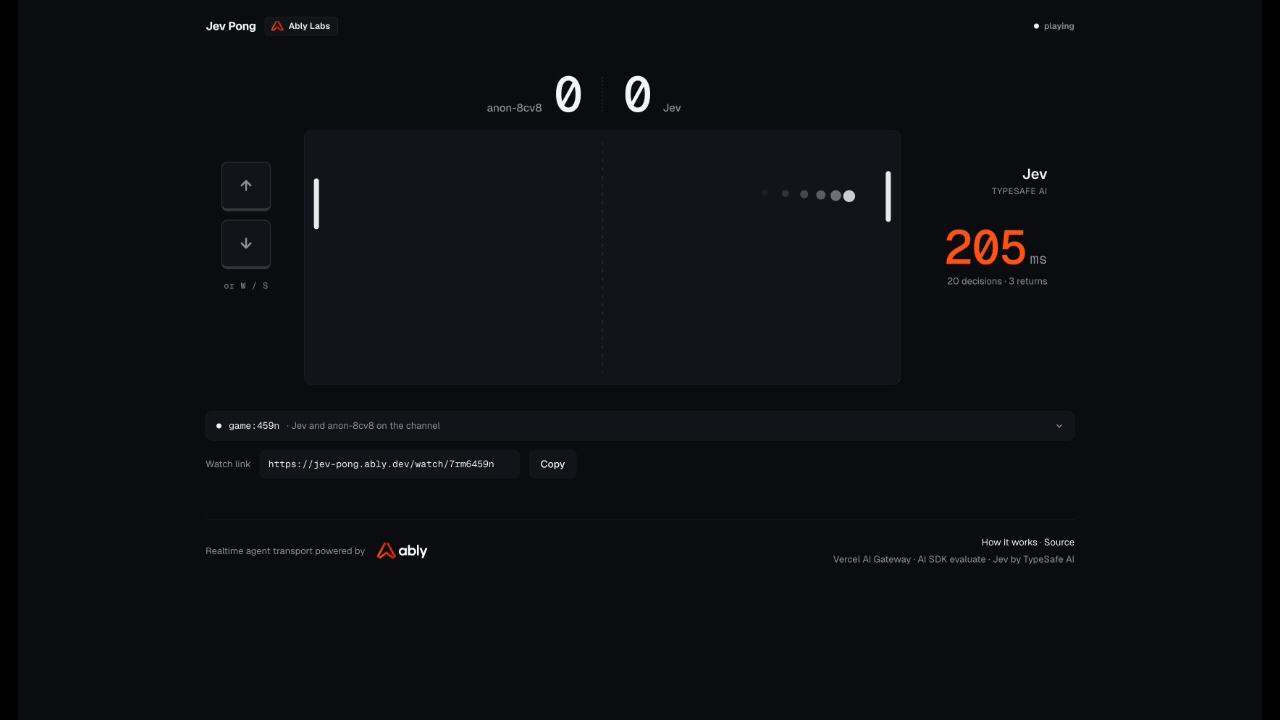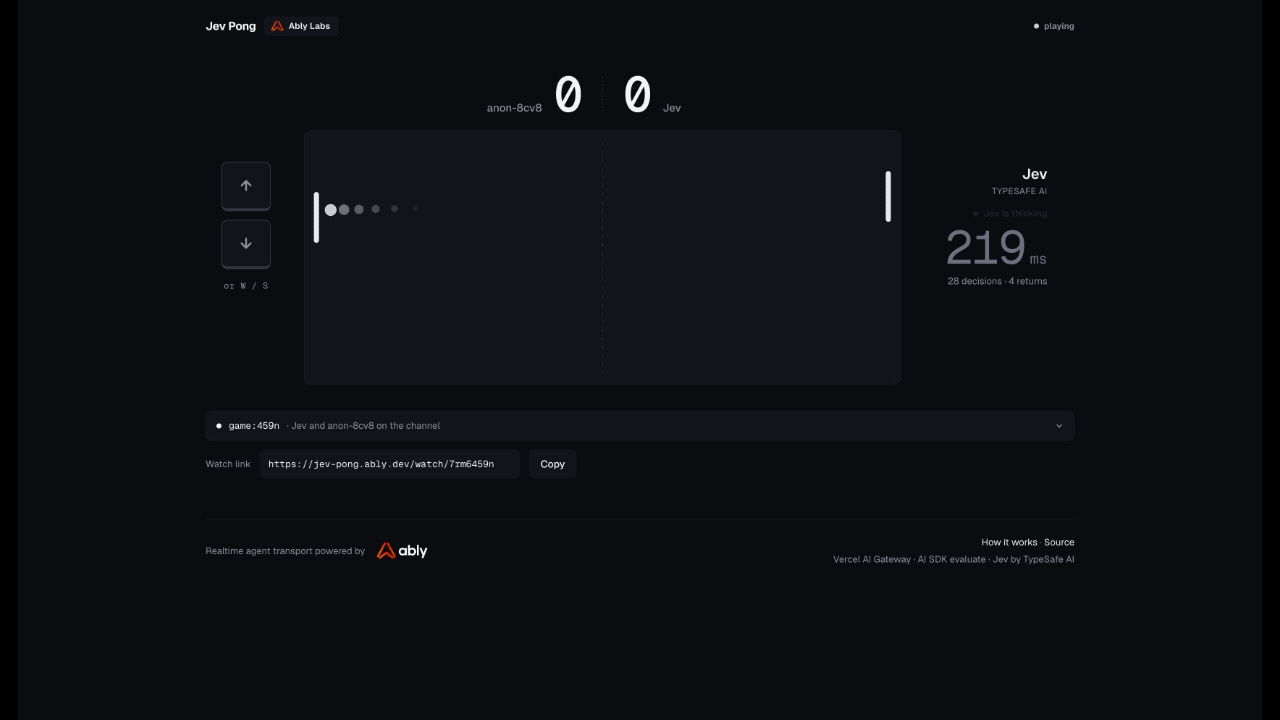
Ably Labs はこのデモを jev-pong.ably.dev で公開している——4レーンが横並びで競走し、decisions/sec・平均・p95・初回応答時間をリアルタイムに表示するパネル付き。「Play against Jev」ボタンもあり、227ms と 3.2s の違いを体感する最速の方法だ。
料金は、10億入力トークンあたり42ドル——100万あたり0.042ドル——で、出力トークンは無料。ローンチ記事の言葉を借りれば「安すぎて計測する意味がない」。これが可能なのは、出力が数フロートであって段落ではないからだ。同社自身のワークフロー評価では、193.6倍速く、444.6倍安い、エンドツーエンドで70〜500msを謳う。
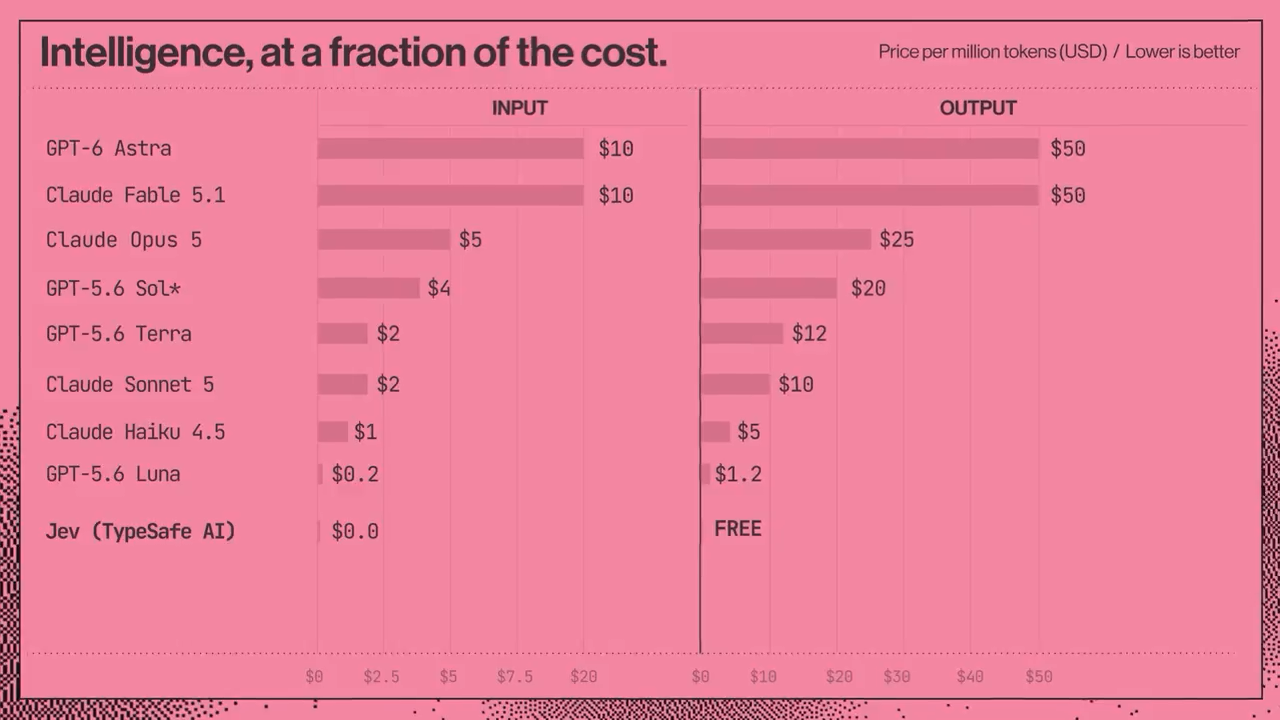
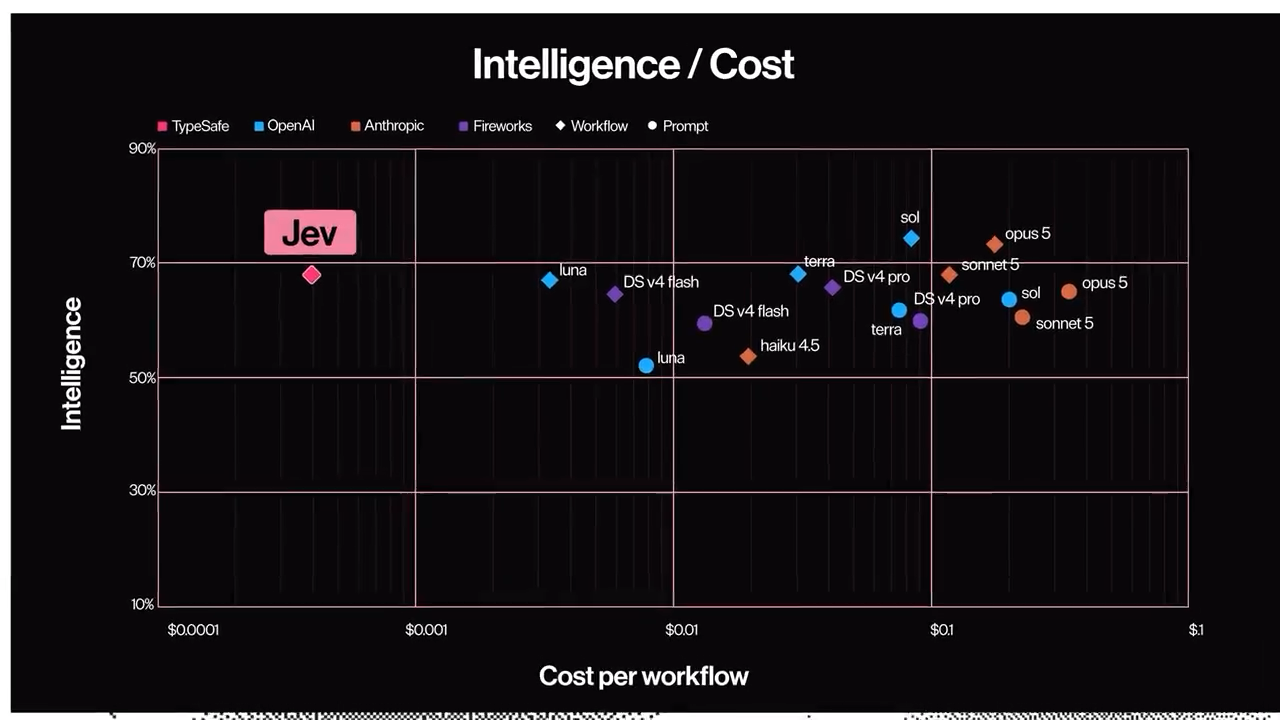
最後の2つの数字には注意が必要だ——公平のために言えば、TypeSafe 自身が先に指摘している。評価ワークフローは「モデルケイパビリティチームの個人が作成したものであり、バイアスの可能性がある」、比較対象の採点は「OpenAIとAnthropicのモデルに有利になる方向」で、結果は「実世界の効果の上限寄り」に位置するという。ローンチ記事の別の、より狭い主張では、単発の System One クエリでは40〜200倍速いとしている。
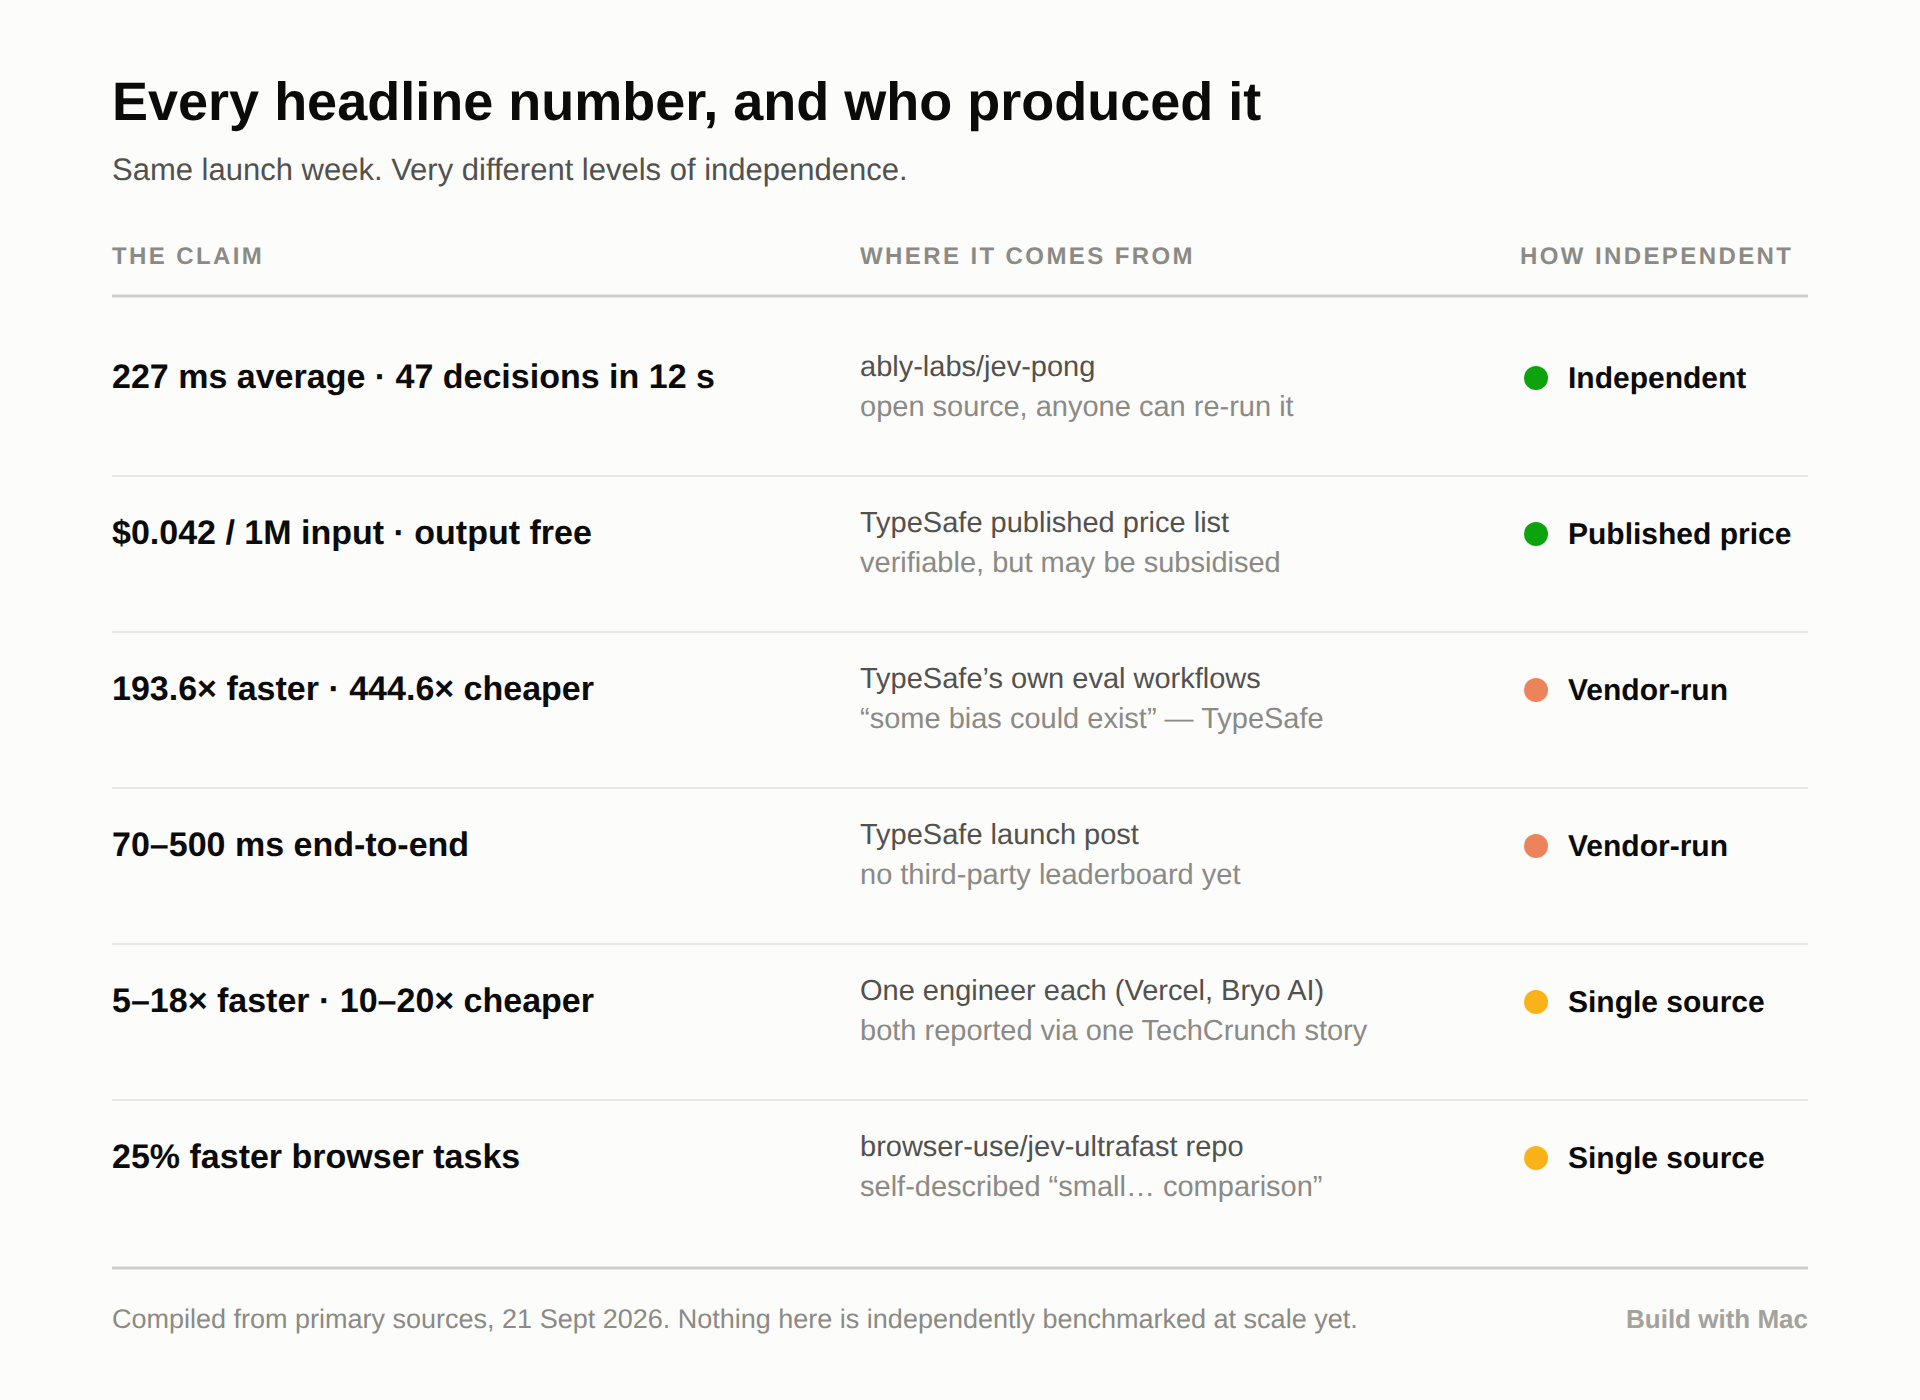
モデル名にもうひとつ注意が必要だ——報道がここをずさんだったので。TypeSafe 自身の評価は GPT-6 Astra と Fable 5.1 を対象にしており、Pong デモは GPT-5.6 Sol、Vercel の内部テストは ChatGPT Luna 5.6。ベースラインが3つあり、数字も3組ある。
もっとも鋭い外からの批判は Hacker News に現れた——LLMのベースラインが同じ答えに辿り着くために完全なチェインオブソートを生成しているなら、70msと数秒の比較は対等ではない。それは正論だ。ただ、少し要点を外している面もある。製品が必要としていたのが答えだけだったなら、チェインオブソートの分のお金は最初から払っていたのだから。
実際に作られているもの
ここが、「単なるベンチマークのおもちゃ」ではないと私を説得した部分だ。
Vercel は Jev を AI Gateway 史上導入が最も速いモデルとして報告した——24時間で有料チームの13%強、GPT-5.6系の約2倍、Fable 5.1の6倍。別途、Vercel のソフトウェアエンジニア Pranit Sharma は TechCrunch に対し、コマンド安全性分類器で ChatGPT Luna 5.6 から Jev に乗り換えたところ、5〜18倍速くなり精度も上がったと語っている。
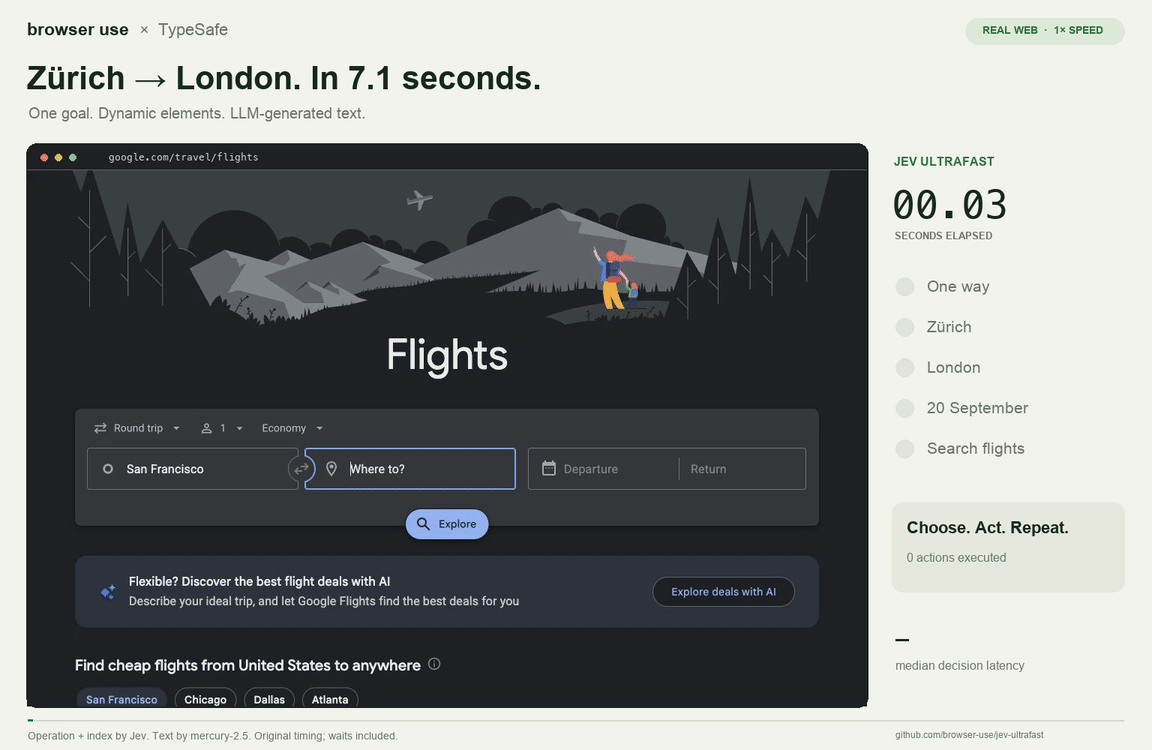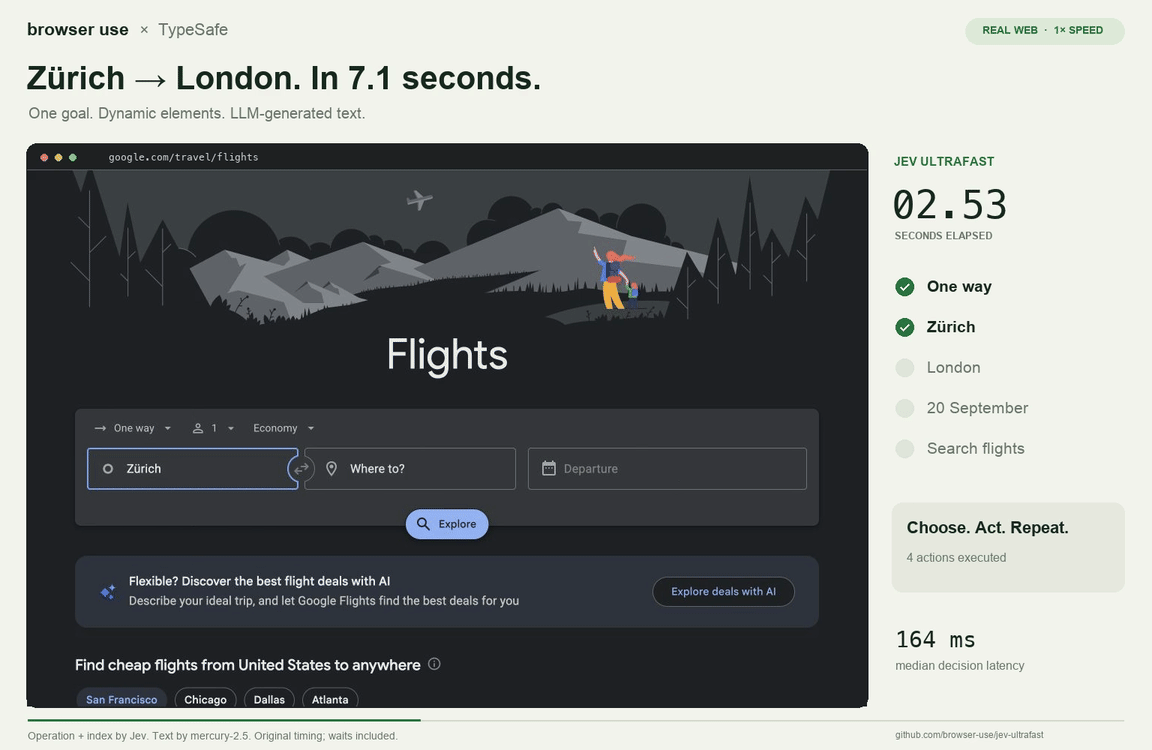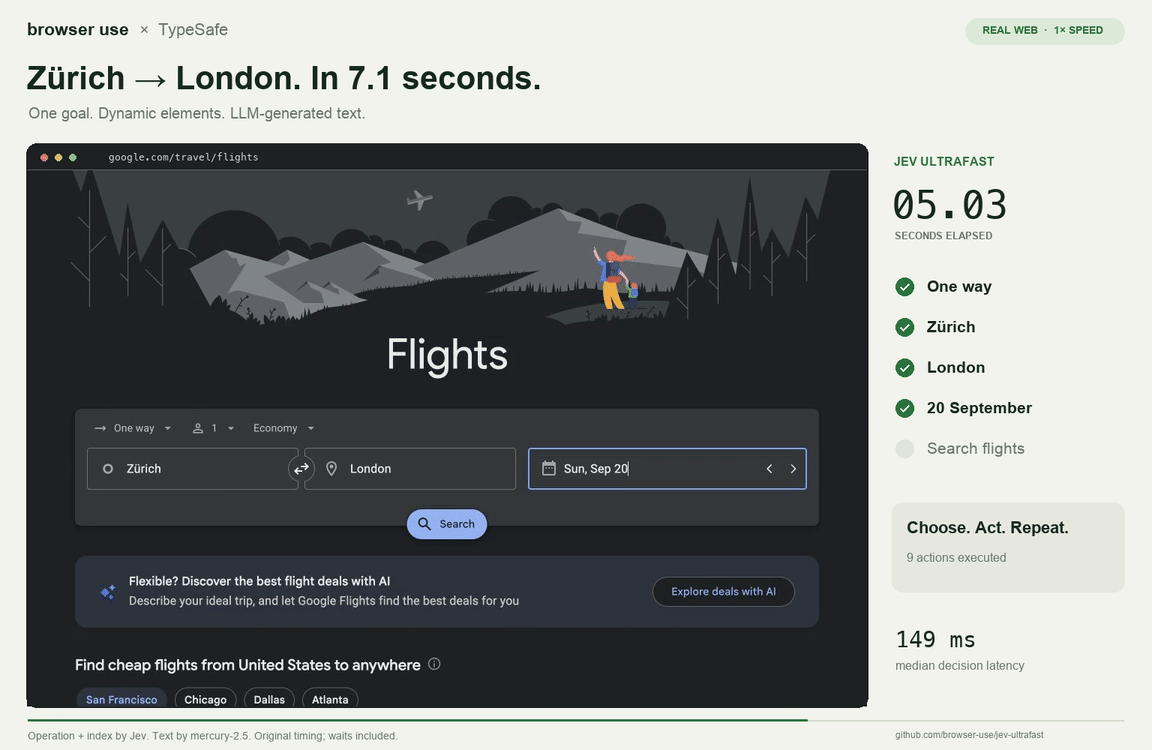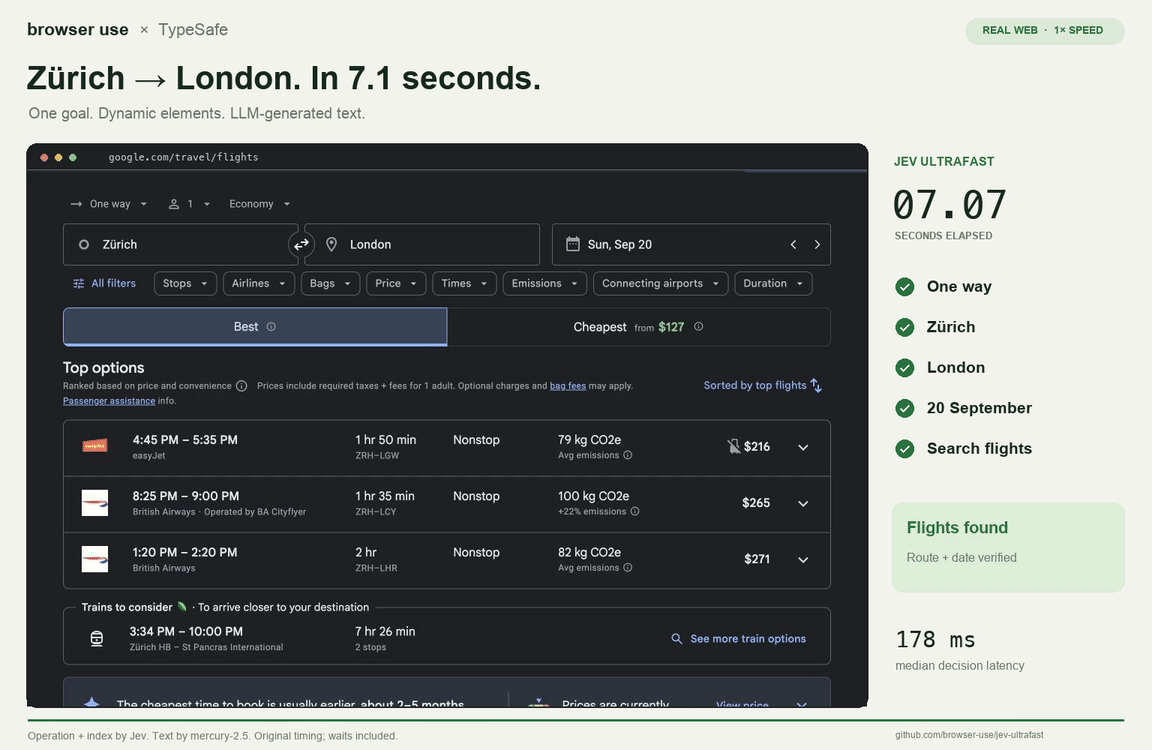
Browser Use は jev-ultrafast をオープンソース化した——1ステップごとに Jev を1回呼ぶブラウザエージェントだ。動作と対象要素を1回のリクエストで選び、実際に文字入力が必要な場合だけ小さいLLMにフォールバックする。タスク時間の中央値は 9.45秒から 7.09秒へ、ブラウザプロトコル呼び出しは 1,092回から 101回に激減した。このリポジトリは「広範なエージェントベンチマークではなく、小さな制御入力の比較だ」と率直に認めている。
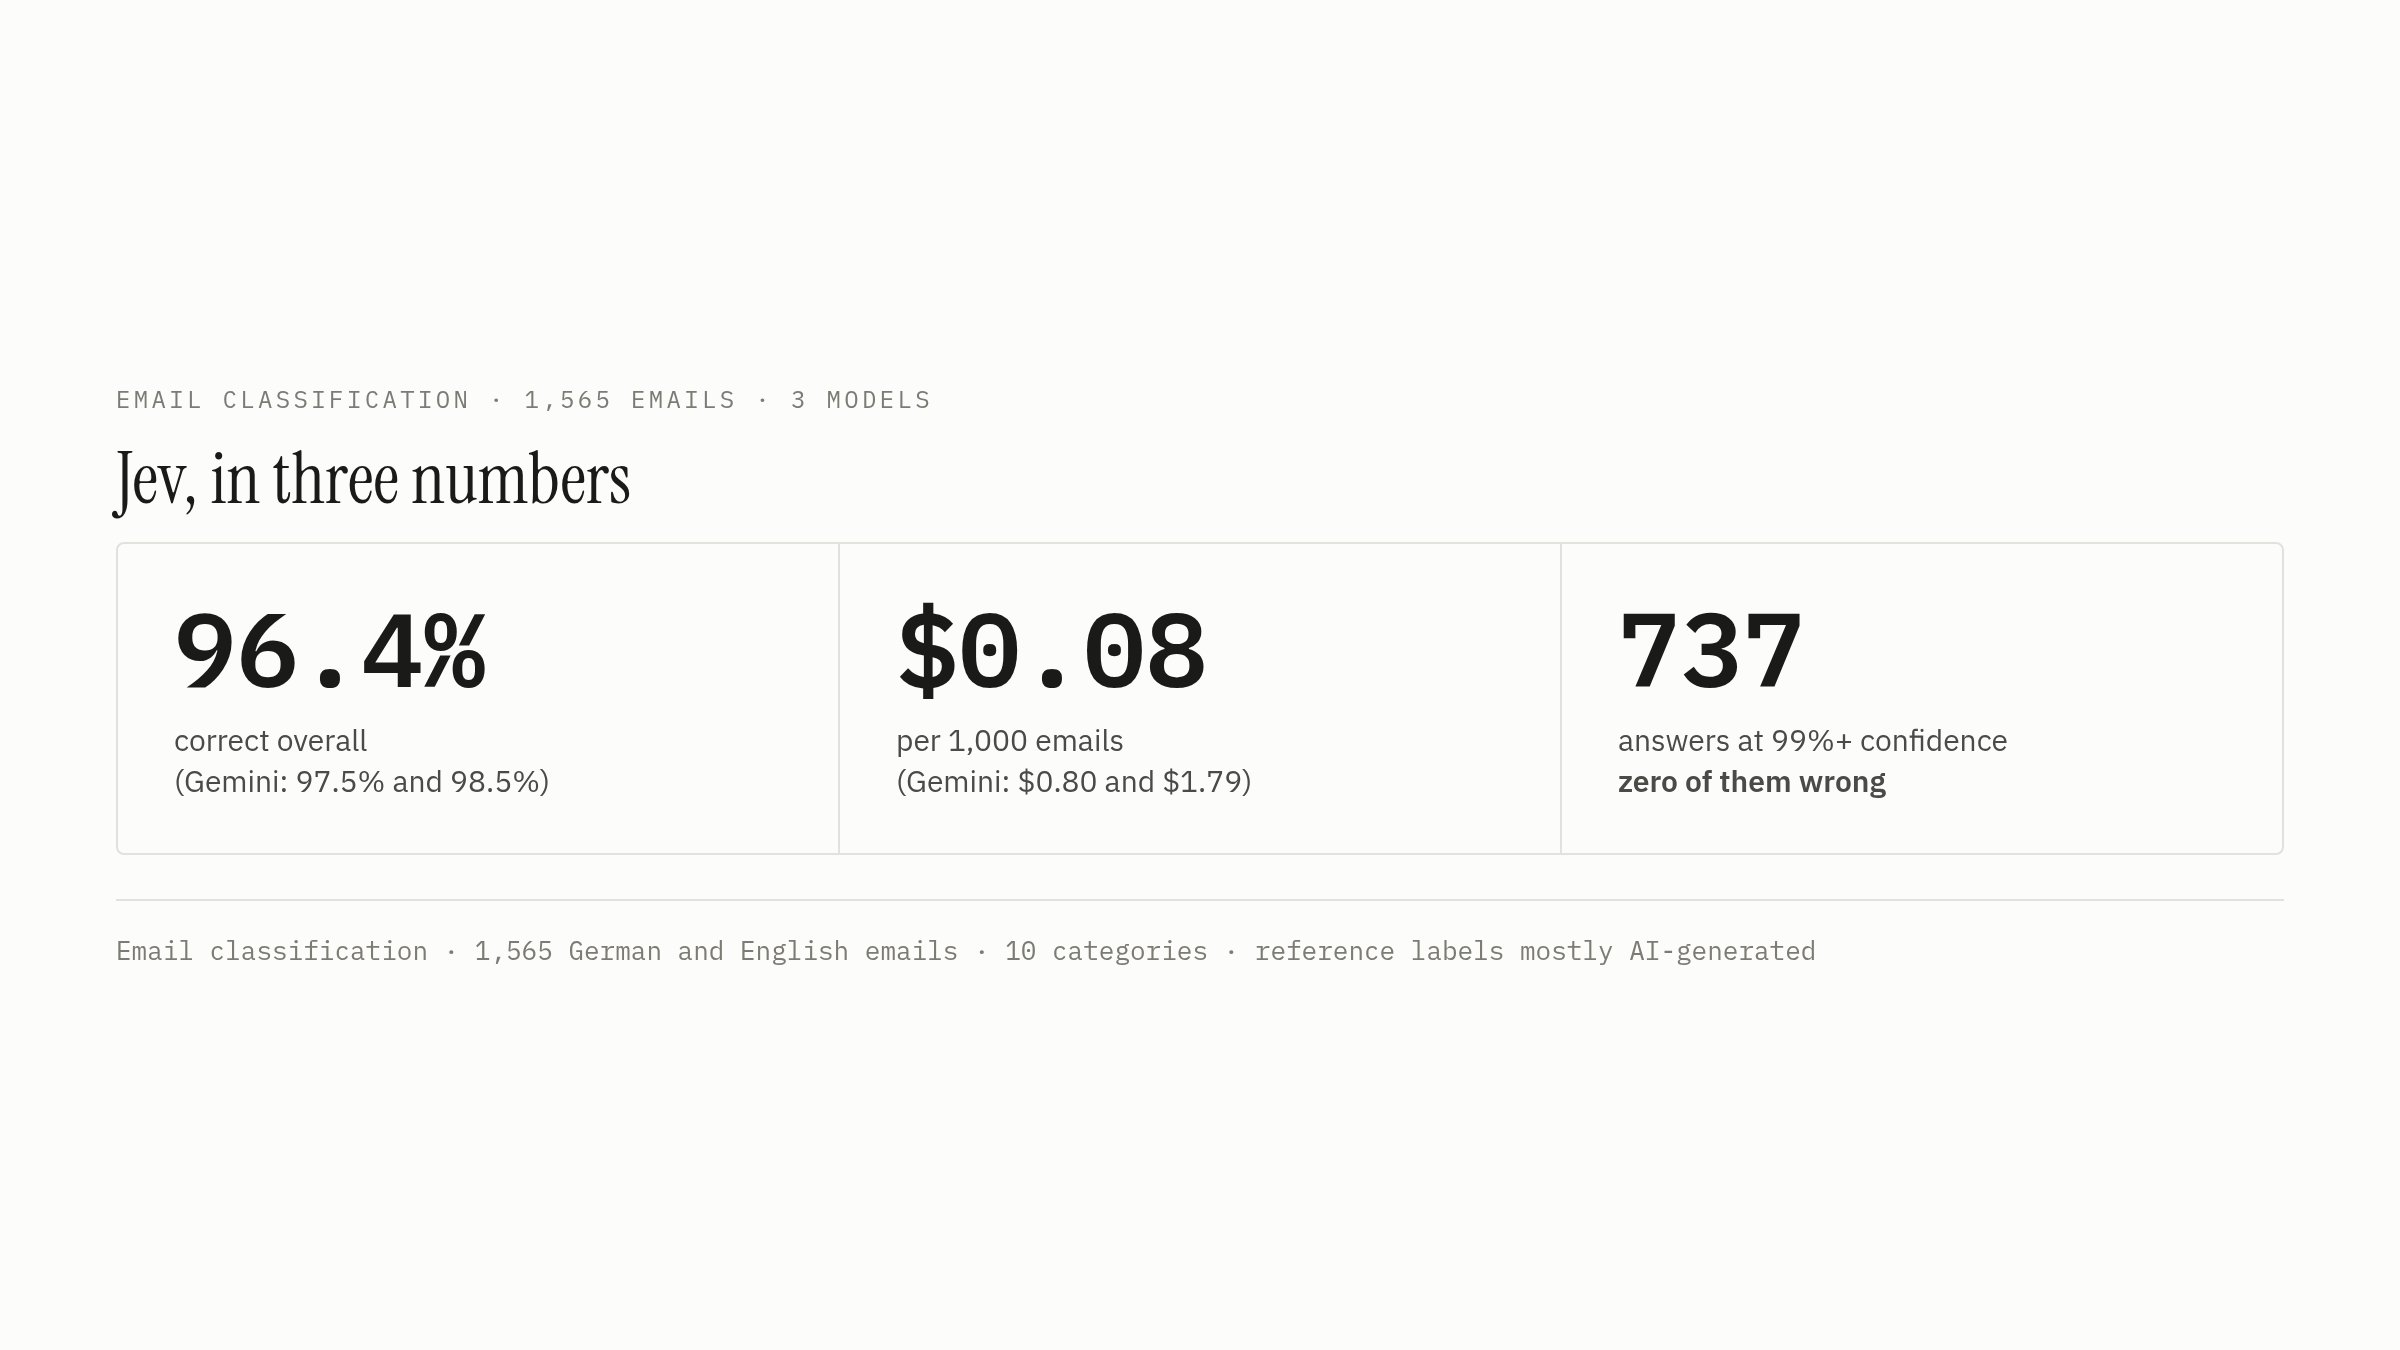
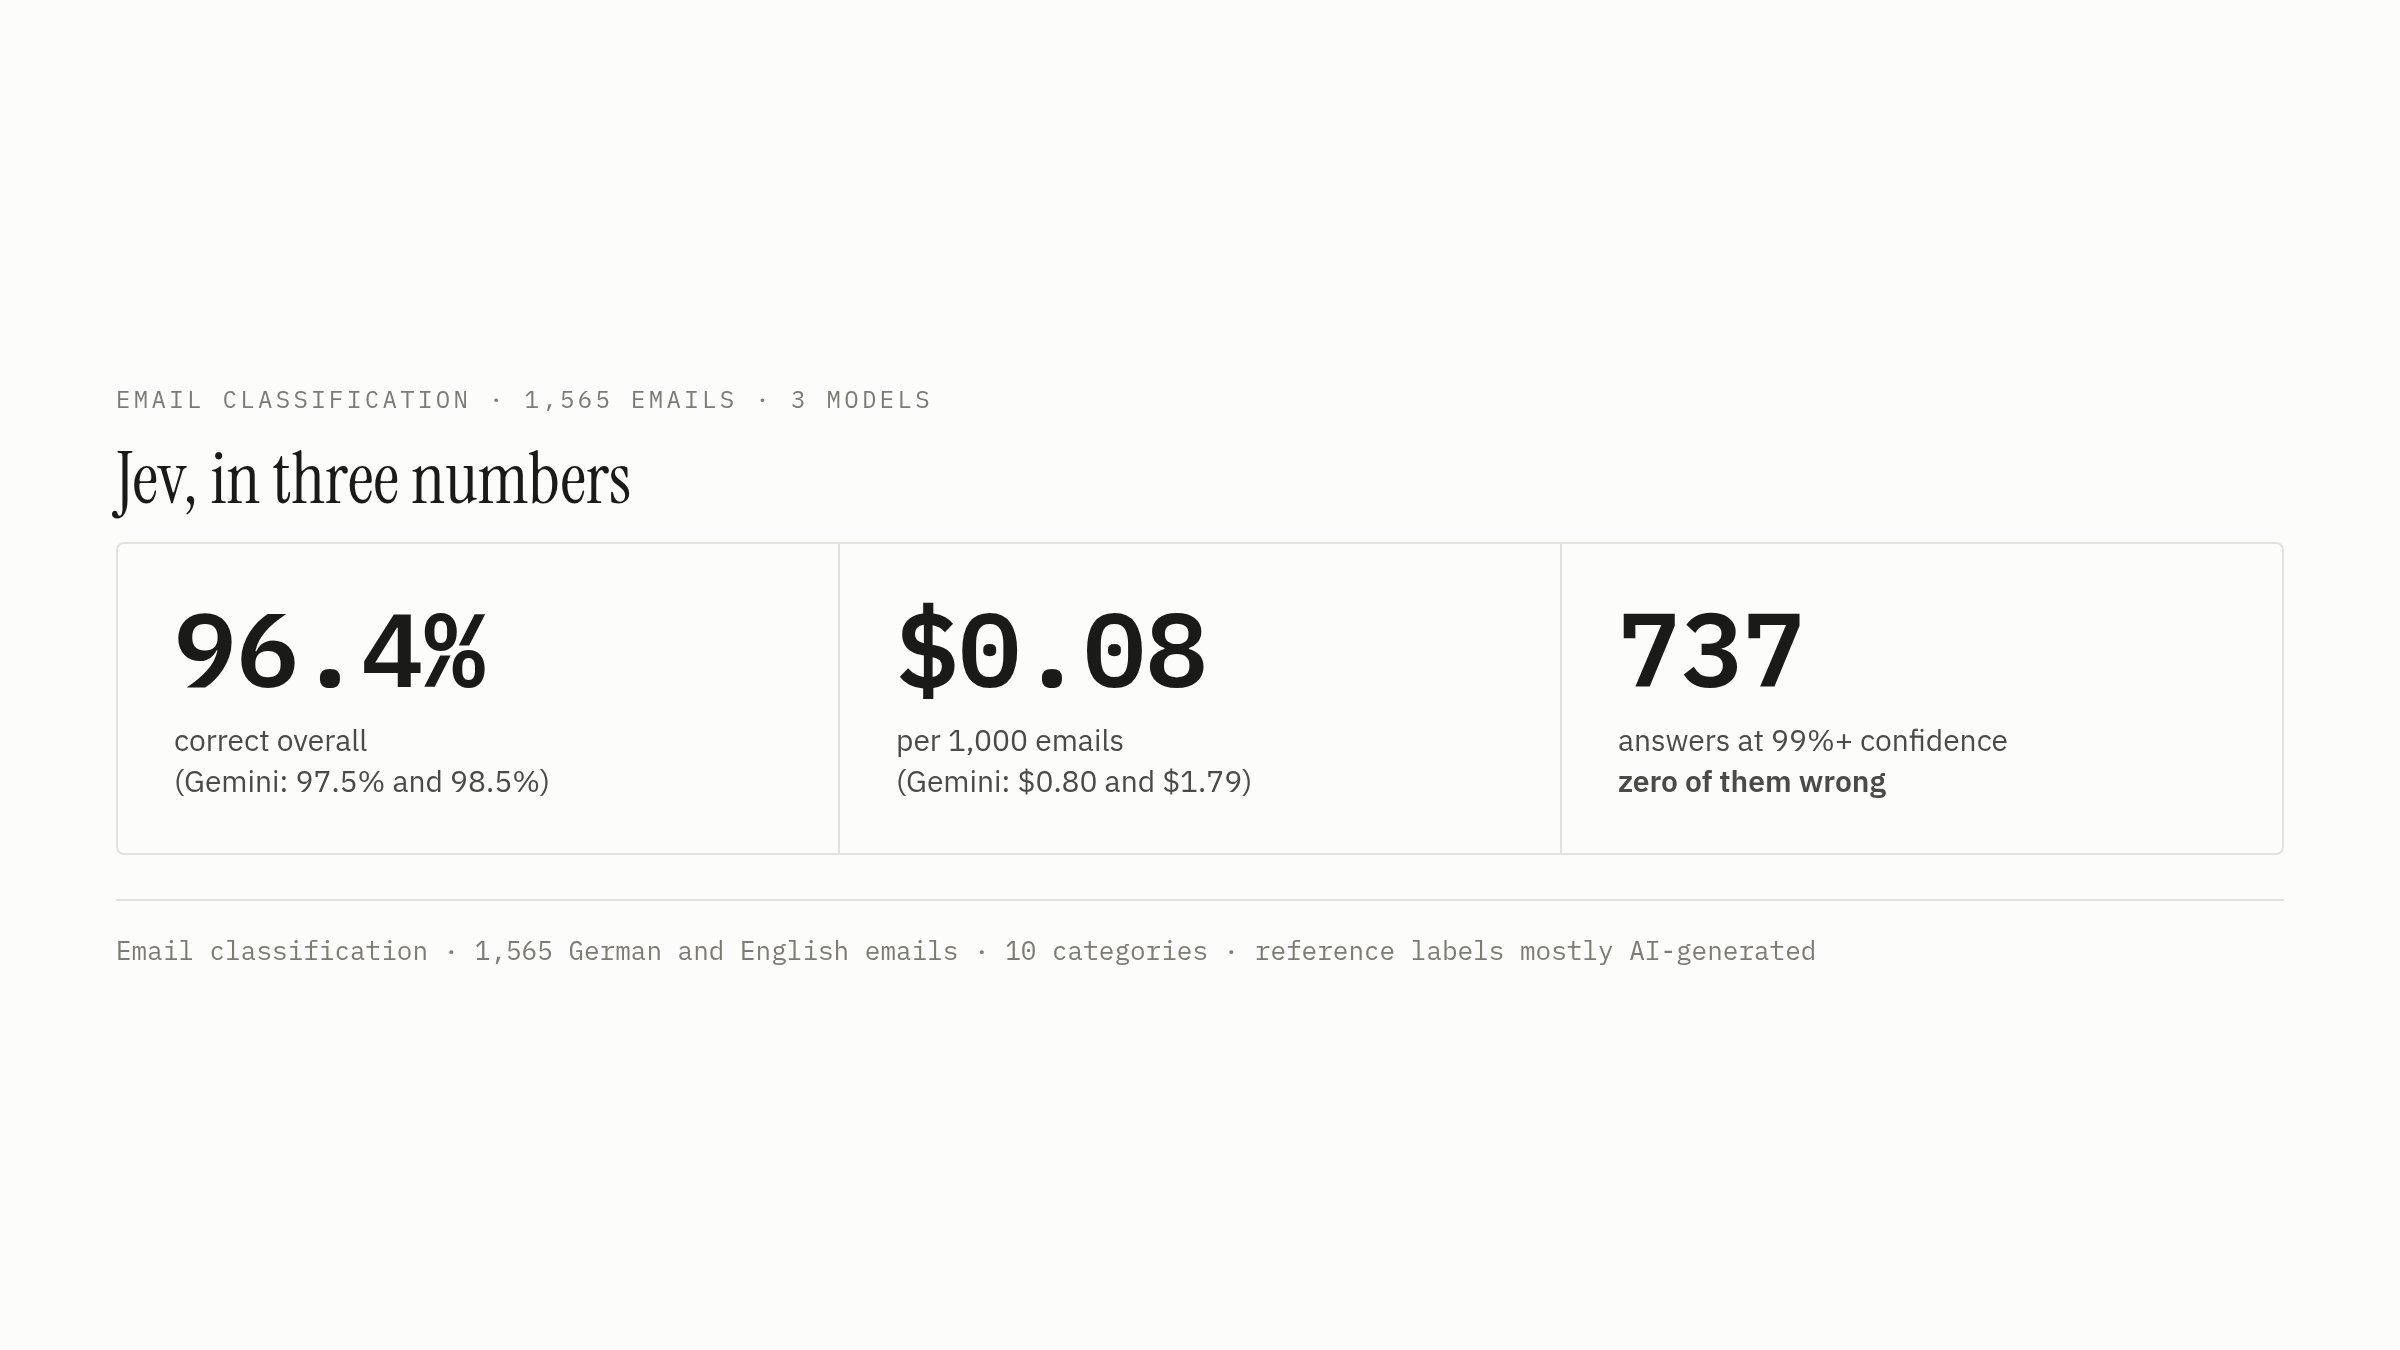
Bryo AI の Nikhil Mudholkar は、ドイツ語と英語のビジネスメール 1,565通を10カテゴリに分類するタスクで Gemini と比較した。精度は Gemini がわずかに上だった——だが Jev は10〜20倍安く、自動化に足る品質の信頼度スコアが返る。
Earendil の共同創業者 Armin Ronacher はモデルルーティングに言及した。タスクが高価なモデルを必要とするかを予測することには価値がある。だが、その予測を高価なモデルでやってしまっては本末転倒だ。彼は本当のトレードオフを一言で言い当てた:
「結局のところ、幻覚(ハルシネーション)の問題を、少しだけユーザに移譲している。」
それは設計上の決断であって欠陥ではない。分布をもらう。閾値をどこに置くかは自分が決める。
まず置きたい4箇所
これらは企業が部品を交換している話だ。私がまず手を出す4箇所は、ひとつのパターンから生じている——そのパターンは、どんなベンチマークよりも2つの週末プロジェクトが雄弁に示している。
GOM の創業者 Ben Jang は、ローカルLLMに Jev を接続して Google Maps に向けた——ローカルモデルがタスク全体を処理し、Jev がクリックのたびごとに判断する。このパターンについて、彼の表現は私が見た中でいちばん美しい言語化だ:
「巨大なフロンティアモデルに、些細なブラウザ操作ひとつひとつを推論させる必要はない。広いタスクはローカルモデルが処理する。Jev が速い判断を処理する……。難しいことには大きなモデル。その間の数百の小さな判断には、小さな専門モデル、と。」
Nailthy Tang は同じ発想をワードローブに実装した。 Drape のための実験では、話しかけると、Jev がトランスクリプトと今着ているものを読み取り、クローゼットから選んで、リアルタイムに着替えさせる。実測コストは判断あたり $0.0011、時間は判断あたり約 620ms。
この2つの数字にはじっくり向き合ってほしい。どちらも、話題の 227ms や「計測する意味がないほど安い」を明確に上回っているからだ。ライブのトランスクリプトと60着のワードローブは、Pongの盤面の125バイトよりはるかに太い state だ。Jev はそれでも速く、それでも安い——ただ、予算は自分のペイロードから計算するべきで、ローンチ記事からではない。
https://x.com/nailthy62/status/2101388186916454439
そして、そのデモの下についたもっとも鋭い返信が、これすべてへの歯止めになっている。要約すると:「Jev はいい。だが、元々数個の if-else と random() で処理できたことを、できるからといってモデルでやってしまう人がたくさんいるはずだ。案の定、なっている。」
その通りだ。だから私が実際に手を出す4箇所には、ひとつの共通点がある。if-else では表現できない、本物の判断が必要な場所だ、という点だ。
1つ目は、いまチャットモデルで回しているすべての分類器だ——意図のルーティング、スパム・悪用のトリアージ、感情分析、優先度スコアリング。これらは衣装を着た Choice と Score の質問であり、ほぼ確実に2オーダー(100倍)分払いすぎている。
2つ目は、エージェントのツール呼び出しへのガードレールだ。Noul の質問——「このコマンドは破壊的か?」——を 200ms で動かせば、すべてのツール実行前に回すのも安い。3秒かかって1回1セントでは、そんなことはとても払えない。LangChain はすでにこのパターンを AutoModeMiddleware として提供している。
3つ目は、コンテキストの圧縮だ。関連性で千個の候補チャンクに並列でスコアを付け、上位だけを残すのは、コサイン類似度より優れたフィルタであり、大きなモデルに全部読ませるコストの何分の一かで済む。
4つ目は、評価(evals) だ。Langfuse は即座に動き出した。LLM-as-a-judge は高く、そして有名なほどキャリブレーションされていない。明示的な順序レベルと本物の信頼度を持つ Score の質問は、そもそも「審判」に求めていたものに近い。
共通する糸はこれだ:これらに必要なのは文ではない。コードが分岐できる「判断」だ。
細かい字の部分
誇大宣伝に対して、実際に刺さるものをここに挙げておく。
「ゼロ幻覚」はスキーマの有効性を指すのであって、正しさではない。 0%という数字は経験的なものではない——出力が定義した型に常に従うという宣言だ。モデルは依然として確率的なので、有効なスキーマの内側で自信満々に間違えることがある。Choice が返せるのは255個の選択肢のいずれかであって、正しいものが返る保証はどこにもない。信頼度スコアを実際の製品として扱い、それに応じて閾値を設定すること。
ローンチ週に公開された中でいちばん教育的だったのは、失敗の話だった。Moon というハンドルの開発者は、「一晩と翌朝」で完全自動の Jev トレーディングボットを作り、Monad のブロックごとに MON/USDC の買いか売りかを決めた。現在130万回以上表示されている投稿での、本人のまとめはこうだ:「現時点で $31,680 失わせてくれた。」
失敗したのはモデルではない。彼の常駐指示がこう書いてあった:「Kuru で MON/USDC を買うか売るか。毎ブロック。棄権は不可。」 Jev の答えは 67% buy / 33% sell——「ここにはほぼシグナルがない」と言う、キャリブレーションされた正直な答えだった。それをハーネスが肩をすくめる仕草のまま1回のトレードに変換し、それを 1,846回、1回約 100ms で繰り返した。これは金額が付いた Ronacher のトレードオフだ:確率こそが製品であり、67% で判断を強制した瞬間、それは捨てられた。速度とキャリブレーションは、そこにないエッジを創り出すわけではない。間違うのを速く、単位あたり安くするだけだ。(ベースになったオープンソースの jev-trader はデフォルトでドライラン——秘密鍵を入れなければ、本物の判断とシミュレーションされた約定が得られる。)
32K コンテキスト、テキストのみ。 ドキュメントは明確だ:「画像・音声・動画は(まだ)サポートされていない」。画面理解や文書処理の広い領域は対象外になる。
価格は暫定と捉えること。 TypeSafe 自身の言葉を借りれば「補助金が出ていないことを証明できない」。アーキテクチャは未公表で、第三者のリーダーボードにもまだ載っていない。5倍の値上げに耐えるコストモデルを組んでおくこと。
名前が論そのものである理由
Jev の名前は、19世紀の経済学者 William Stanley Jevons(ジェヴォンズ)に由来する。石炭の利用効率を上げると、燃える量は減るどころか増える——という観察をした人物だ。単位コストの低下は、総利用量を拡大する。
Almeida が賭けているのは、知性にも同じことが起きるという点だ。100万入力トークンあたり $0.042、200ms の世界では、モデル呼び出しを配給制にする必要がなくなる——かつてはネットワーク往復と1セントのコストを理由に、判断を入れる価値のなかった場所に、判断を置き始める。すべてをやる巨大なエージェントひとつではなく、ありふれたソフトウェアに散らばる何千もの小さな判断だ。彼の言うように、いま皆が作ろうとしているメガアプリより、初期のインターネットに近い。
「フロンティアラボの主なプロダクトは恐怖か誇大宣伝だ。我々の主なプロダクトは知性でありたい。」—— Diogo Almeida
ラベルについて最後にひとつ。会話もできないものを「フロンティアモデル」と呼ぶのは、競争したことのないカテゴリの信用を借りる行為だ。Jev はごく狭いことにかけて非常に優れている——それが売りであり、しかも強い売りだ。「フロンティア」のバッジはいらない。
TypeSafe の数字が独立した精査に耐えるかは、実際にまだわからない。わからなさそうにないのは、このアイデアの形だ。いま私たちがAI機能と呼んでいるものの多くは、とても高価なコートを着た if 文ひとつに過ぎない。Jev は、「問題はコートのほうだ」という前提で作られた最初のモデルだ。
モデルが話さなくなった。ソフトウェアがやることを増やした。
自分で試す
これらはどれも API キーは不要だ。ブラウザで動く。
- Jev Pong — 上のレイテンシベンチマークを、実際のレースとして。ボールの速さが判断の速さだ。
- Jev Pac-Man — スクリーンショットも経路探索もなしに、構造化 state から迷路を攻略する。0.25x に落とせば、Choice がひとつひとつ下されるのを眺められる。
- Jev Tetris — Choice プリミティブが、回転と落下位置を毎手選ぶ。
- Jev Trader — 300ms のブロックウィンドウの中でのオンチェーン判断。
- Jev Guard — コメントモデレーション。上記のツール呼び出しガードレールのパターンにいちばん近い公開デモ。
- Smart Home — TypeSafe 自身のインタラクティブデモ。
ブックマークしておく価値があるもう2つ。TypeSafe は評価方法論とチャートをすべて evals.typesafe.ai で公開している——自分で採点対象のワークフローを検査できるからこそ有用だ。そして madewithjev.com は、ローンチ初週に作られた143のオープンソースプロジェクトを索引している。これがどこに着地するかを知るには、どんなベンチマークより良い指標になる。
出典
- Introducing System One Models & Jev — TypeSafe AI
- TypeSafe AI API reference
- A new kind of AI model from a ChatGPT inventor is thrilling developers — TechCrunch
- TypeSafe AI debuts model for machines that plays Doom — The Register
- TypeSafe AI Emerges From Stealth With $40M in Funding — AIwire
- ably-labs/jev-pong — GitHub
- browser-use/jev-ultrafast — GitHub
- Building a harness with Jev — LangChain
- Jev (typesafe) — Cloudflare AI docs
- Using TypeSafe’s Jev for evals — Langfuse
- TypeSafe AI Releases Jev — MarkTechPost
- Is the 200x Faster Decision Model Too Good to Be True? — Flowtivity
- TypeSafe AI’s Decision Model Jev Becomes Vercel’s Fastest Adopted Launch — Startup Fortune